Đệ quy có chậm hơn vòng lặp không?
So vòng lặp với đệ quy bằng benchmark C++ và Python, kiểm assembly, tách chi phí lời gọi khỏi thuật toán, rồi xét mối liên hệ với tư duy toán học.

Cộng mảng [1, 2, 3, 4], ta có thể viết một vòng lặp hoặc để hàm tự gọi với phần mảng còn lại. Cả hai đều đọc bốn số và trả về 10. Nếu đổi thành mảng dài hơn, cả hai cùng làm một lượng công việc tăng tuyến tính theo số phần tử.
Bài Đệ Quy Khiến Bạn Trở Thành Kỹ Sư Tồi cảnh báo về stack và chi phí gọi hàm. Còn bài Cùng O(n), vì sao thời gian chạy khác nhau? cho thấy compiler có thể thay đổi đáng kể cách CPU thực hiện một vòng lặp. Đặt hai cách giải thích cạnh nhau, cần kiểm tra xem lời gọi đệ quy có còn tồn tại trong mã máy hay không. [1] [2]
Cộng cùng một mảng
Ba hàm dưới đây cùng nhận địa chỉ mảng a, số phần tử n và tổng ban đầu acc. Khi gọi từ benchmark, acc bằng 0.
uint32_t sum_loop(const uint32_t* a, size_t n, uint32_t acc) {
    for (size_t i = 0; i < n; ++i) acc += a[i];
    return acc;
}

uint32_t sum_rec(const uint32_t* a, size_t n, uint32_t acc) {
    if (n == 0) return acc;
    return a[0] + sum_rec(a + 1, n - 1, acc);
}

uint32_t sum_tail(const uint32_t* a, size_t n, uint32_t acc) {
    if (n == 0) return acc;
    return sum_tail(a + 1, n - 1, acc + a[0]);
}
Ở sum_rec, hàm phải đợi lời gọi bên trong trả kết quả rồi mới cộng a[0]. Với bốn số, các phép cộng chờ nhau theo dạng 1 + (2 + (3 + (4 + 0))).
Ở sum_tail, hàm cộng trước rồi truyền tổng mới sang lần gọi tiếp theo. Tổng đi qua các mốc 0, 1, 3, 6, 10; sau lời gọi cuối không còn phép tính nào đang chờ. Đây là tail recursion, hay đệ quy đuôi. Vòng for cũng cập nhật tổng theo các mốc ấy, nhưng giữ việc cập nhật trong cùng một lần gọi hàm.
Con trỏ a + 1 chỉ chuyển sang phần tử kế tiếp. Code không sao chép mảng con. Chi tiết này tránh đưa thêm chi phí cấp phát hay sao chép vào phép so.
Bộ benchmark dùng mảng giả ngẫu nhiên thay cho dãy [1, 2, 3, 4], để chương trình phải đọc dữ liệu thật. Phép đo ngày 05/10/2026, trên Apple M4 Pro, Apple Clang 21.0.0, cho kết quả sau ở mảng 4.096 số uint32_t, tương đương 16 KiB. Mỗi hàng tổng hợp 12 mẫu; một mẫu gồm nhiều lượt cộng toàn mảng sau khi làm nóng dữ liệu.


Bảng dựng trực tiếp từ dữ liệu native.csv. Ba hàng tô vàng dùng -O3 với tối ưu đệ quy mặc định. Khoảng min-max giữ cả mẫu chậm, không phải khoảng tin cậy. Link dưới mỗi ảnh mở bản ở kích thước gốc.
Ba bản đầu đều mất khoảng 0,11 microsecond cho một lần cộng toàn mảng. Chênh lệch giữa chúng nhỏ hơn độ dao động của các mẫu đo, nên phép thử này chưa cho cơ sở xếp hạng bản nào nhanh hơn.
Khi biên dịch, Clang ghi lại việc chuyển cả hai hàm đệ quy thành vòng lặp:


Phần trên giữ nguyên compiler diagnostics; phần dưới trích assembly của sum_rec. Vùng vàng đánh dấu phép biến đổi và các lệnh cộng vector.
Trong assembly của sum_rec và sum_tail không còn lệnh gọi lại chính hàm đó. Clang tiếp tục vectorize vòng lặp đã tạo ra. Lệnh add.4s cộng bốn cặp số nguyên 32 bit trong các thanh ghi vector; thân vòng lặp chính xử lý 16 phần tử mỗi lượt.

Sơ đồ mô tả phép cộng uint32_t đã đo: compiler xử lý từng phiên bản độc lập. Các mũi tên không nối ba cách viết thành một chương trình.
Tên pass của LLVM là Tail Call Elimination, nhưng phạm vi xử lý của nó còn có một số hàm chưa ở dạng tail recursion. Nếu phép toán sau lời gọi cho phép biến đổi sang accumulator, compiler có thể chuyển hàm đó về vòng lặp. Phép cộng unsigned trong sum_rec vừa đo thuộc trường hợp ấy. [3]


Trích đoạn dàn lại từ Tail Call Elimination, giữ nguyên lời nguồn. Dấu [...] đánh dấu phần lược bỏ.
Khi giữ lại lời gọi đệ quy
Hai hàng cuối của bảng dùng thêm cờ -fno-optimize-sibling-calls. Đây là đối chứng có chủ đích: giữ lời gọi tự đệ quy để xem thời gian thay đổi ra sao, thay vì coi source có đệ quy là máy chắc chắn sẽ gọi đệ quy.
Assembly của hai bản này có lệnh bl gọi lại chính hàm. Thời gian tăng lên khoảng 19,9 microsecond với đệ quy thường và 19,6 microsecond với tail recursion.
Phép so từ 0,11 lên gần 20 microsecond đồng thời thay đổi nhiều việc. CPU phải gọi rồi trở về qua nhiều mức hàm, lưu và khôi phục trạng thái trên stack; compiler cũng không tạo được vòng lặp SIMD như trước. Tỷ lệ giữa hai số ấy bao gồm cả chênh lệch SIMD và cách dùng stack.
Hai bản scalar giúp kiểm tra thêm. Vòng lặp tắt vectorization và unrolling mất khoảng 0,94 microsecond. Bản tự tách thành bốn tổng riêng, vẫn không dùng SIMD, còn khoảng 0,34 microsecond. Cách tổ chức các phép cộng đã ảnh hưởng đến thời gian trước cả khi xét lệnh vector.
Với các phép cộng có thể sắp lại như trong benchmark này, LLVM nhận diện biến tổng là một reduction, tạo các tổng riêng rồi gộp ở cuối. Số thực có thêm ràng buộc: đổi thứ tự cộng có thể đổi kết quả, nên không thể áp dụng nguyên trạng kết luận từ uint32_t sang float hoặc double. [4]
Python vẫn phải thực hiện những lời gọi ấy
Phép thử tiếp theo giữ cách duyệt bằng chỉ số, không tạo slice, nhưng chạy trong CPython 3.14.3. Mảng gồm 512 phần tử để hai bản đệ quy vẫn nằm dưới recursion limit mặc định.


Bảng tổng hợp từ python.csv, nhóm array512. Kết quả thử riêng ở độ dài 1.500 nằm trong python-metadata.json.
Vòng for mất khoảng 7,8 microsecond; đệ quy thường mất 21,2 microsecond. Đổi sang tail recursion còn tăng thời gian lên 26,5 microsecond trong phép thử này. Hình dạng tail recursion tự nó chưa làm mất lời gọi hàm.
Tài liệu Python 3.14 nói rõ CPython chưa thực hiện tail-call optimization cho hàm Python. Tính năng có tên tail-call interpreter dùng tail call bên trong phần triển khai interpreter bằng C, không chuyển hàm Python tự gọi thành vòng lặp. Bản Python dùng để đo cũng không bật tính năng interpreter đó. [5]
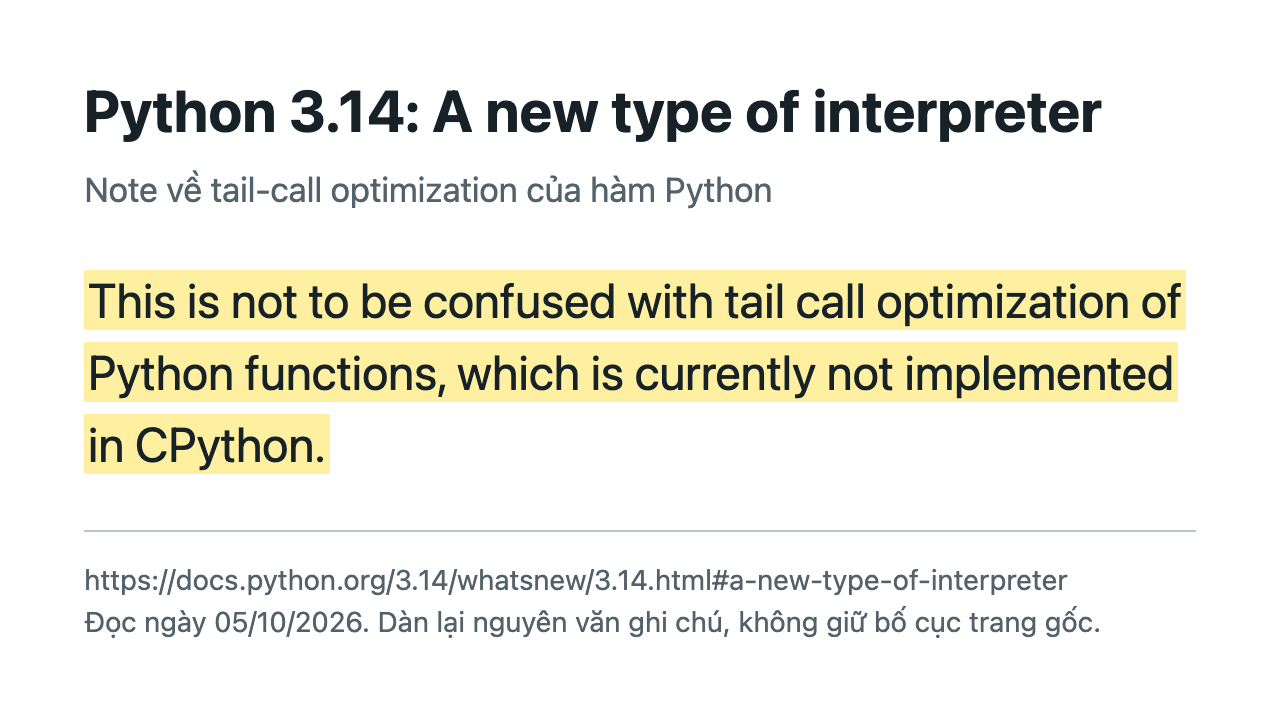

Nguyên văn ghi chú trong A new type of interpreter, dàn lại để đọc rõ. Phần vàng xác định phạm vi của tính năng.
Khi tăng mảng lên 1.500 phần tử và giữ recursion limit ở 1.000, hai bản đệ quy báo RecursionError. Hai vòng lặp vẫn trả đúng tổng.
Cây cân bằng và stack tự quản lý
Với cây, cách viết đệ quy theo sát cấu trúc dữ liệu: tính tổng cây trái, tính tổng cây phải, cộng thêm số ở node hiện tại. Một bản lặp có thể dùng list làm stack để giữ những node chưa xử lý.

Bên trái là các lời gọi lồng nhau khi đang đi xuống một nhánh. Bên phải là danh sách nhánh chờ, lấy left ra trước right. Hai hình minh hoạ cách giữ trạng thái, không mô tả cùng một thời điểm của phép duyệt.
Benchmark dùng cùng một cây cân bằng có 32.767 node, gồm 15 tầng không rỗng. Chương trình tạo cây trước khi bắt đầu đo. Bản stack đầu tiên đẩy cả hai nhánh con vào danh sách rồi mới kiểm tra None lúc lấy ra; bản thứ hai kiểm tra trước khi đẩy.
# Bản stack đầu tiên
stack.append(right)
stack.append(left)

# Bản bỏ nhánh rỗng trước khi đẩy
if right is not None:
    stack.append(right)
if left is not None:
    stack.append(left)


Nhóm tree32767 trong python.csv. Mỗi bản trả cùng tổng; vùng vàng đối chiếu đệ quy với bản stack đã bỏ nhánh rỗng.
Bản đệ quy mất khoảng 1,55 millisecond, nằm giữa hai bản stack: 2,09 millisecond và 1,29 millisecond. Chặn nhánh None trước khi push giảm số lượt pop từ 65.535 xuống 32.767. Hai cách viết vòng lặp đã cho kết quả khác nhau dù cùng dùng một list làm stack.
Dùng stack thủ công giúp lập trình viên kiểm soát phần trạng thái này, nhưng nó vẫn chiếm bộ nhớ. Với những cách duyệt depth-first vừa dùng, lượng trạng thái cần giữ có cận trên theo chiều cao cây. Cây cân bằng giữ độ sâu ở mức \(O(\log n)\); cây lệch có thể làm độ sâu đệ quy tăng đến \(O(n)\). Một số cách duyệt lặp có thể dùng ít hơn cận trên đó trên những hình dạng cây cụ thể.
Fibonacci và những kết quả bị tính lại
Công thức \(F_n = F_{n-1} + F_{n-2}\) rất dễ chuyển thành hàm tự gọi hai nhánh:
def fib_naive(n):
    if n < 2:
        return n
    return fib_naive(n - 1) + fib_naive(n - 2)
Để tính F(5), nhánh F(4) đã phải tính F(3). Sau khi nhánh đó xong, hàm lại gọi F(3) một lần nữa. Đi sâu thêm sẽ gặp nhiều kết quả bị tính lại.

Phần cây lời gọi này giữ lại hai vị trí tính F(3), tô xám. Các lời gọi nhỏ hơn chưa được mở rộng.
Với F(32), cách triển khai này thực hiện 7.049.155 lời gọi, tính cả lời gọi đầu tiên và các trường hợp cơ sở. Số này suy ra từ công thức đếm C(n) = 1 + C(n-1) + C(n-2), với C(0) = C(1) = 1; không chèn bộ đếm vào các lượt đo thời gian.
Một bản tail recursion mang theo hai số Fibonacci liên tiếp chỉ cần 32 bước chuyển trạng thái:
def fib_tail(n, a=0, b=1):
    if n == 0:
        return a
    return fib_tail(n - 1, b, a + b)


Nhóm fib32 trong python.csv. Đơn vị của toàn bảng là microsecond. Bản memoization xóa cache trong mỗi lượt tính, nên không đo việc lấy lại một đáp án đã có từ lượt trước.
Đệ quy ngây thơ mất khoảng 147 millisecond, còn vòng lặp khoảng 0,41 microsecond. Khi giữ thuật toán tuyến tính và dùng tail recursion, thời gian là khoảng 0,80 microsecond. Memoization cũng loại bỏ phần lớn việc tính lại, đổi lấy thao tác quản lý cache.
Số lời gọi của bản ngây thơ tăng theo hàm mũ. Các bản dùng hai số liên tiếp chỉ cần số bước tuyến tính; cách đếm này chưa tính chi phí số nguyên lớn khi tăng n. So bản ngây thơ với vòng lặp vì thế không tách được riêng chi phí lời gọi đệ quy.
Đoạn Java trong bài cũ còn có một lỗi độc lập với performance. Với n = 10, bản đệ quy trả 55 nhưng vòng lặp với điều kiện i < n trả 34. [1]
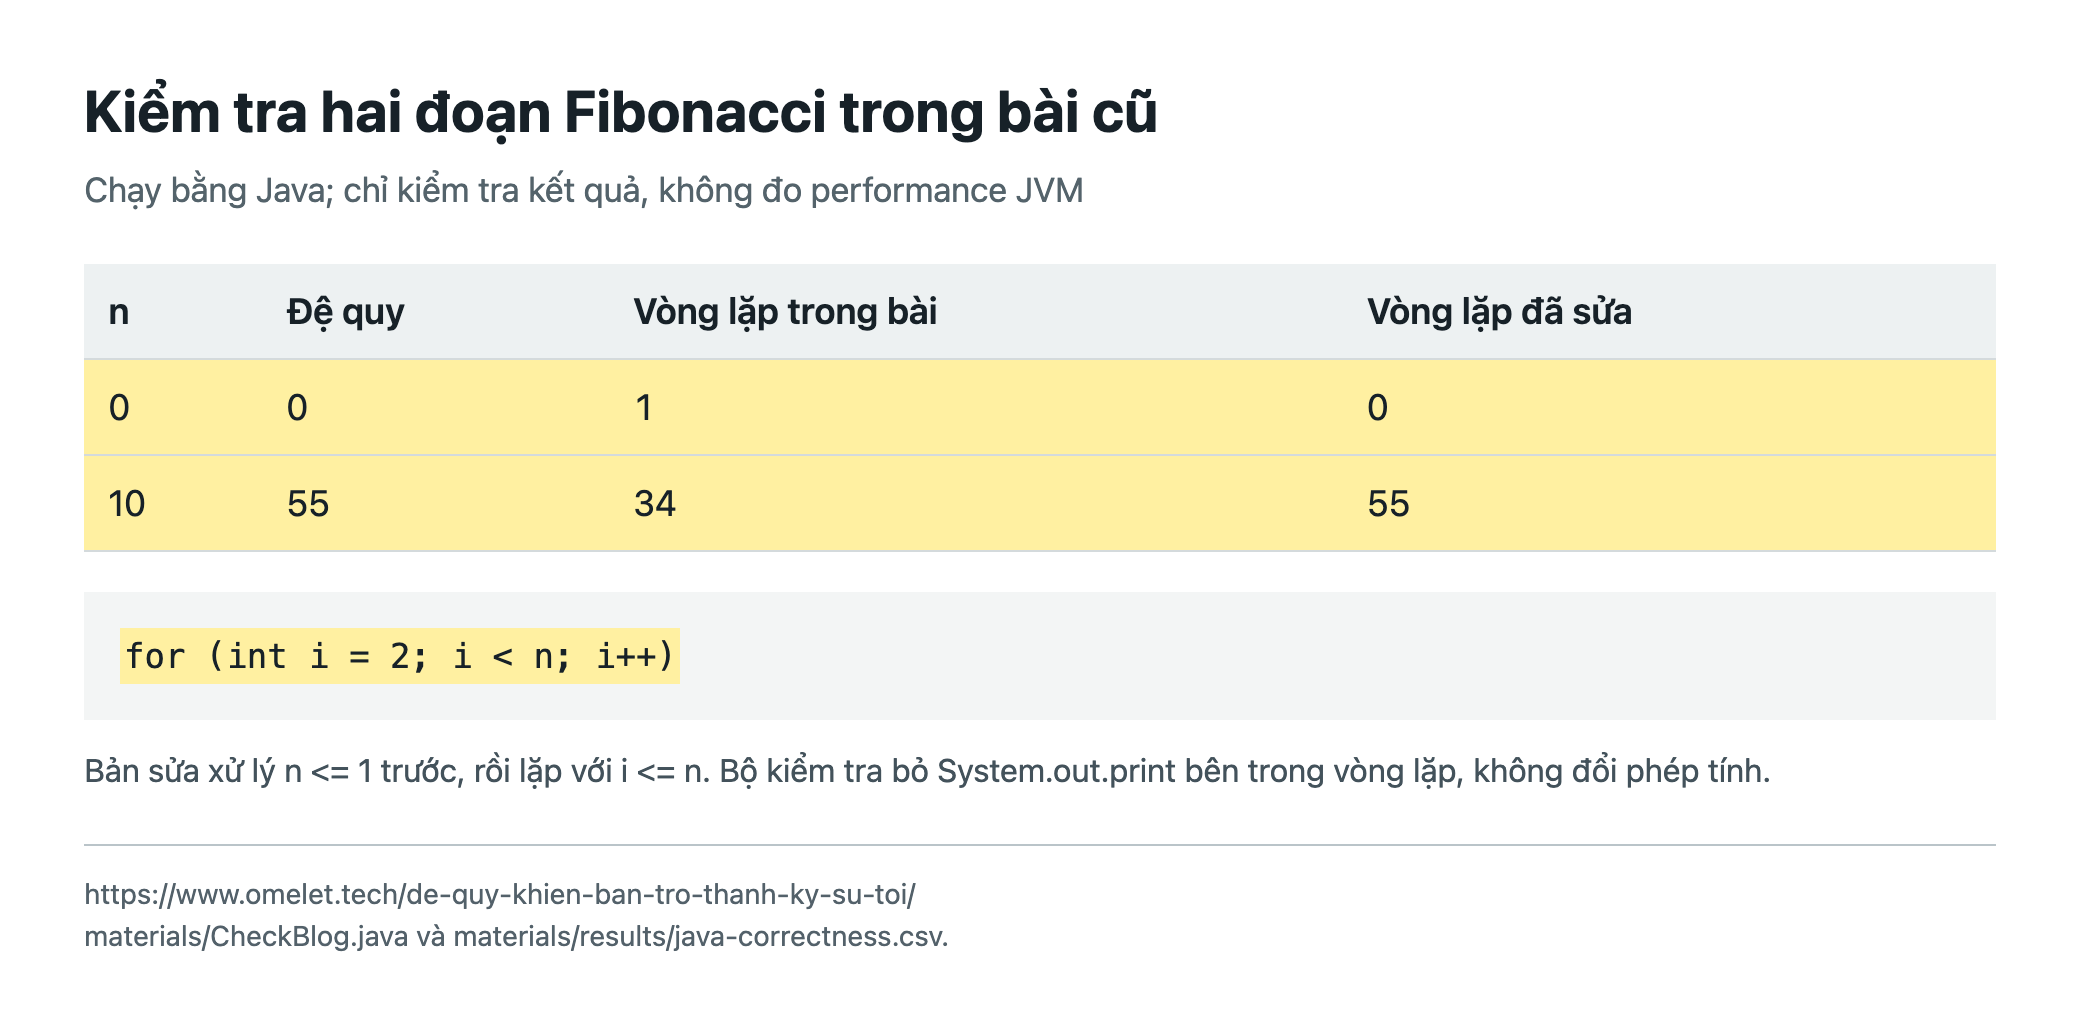

Đầu ra từ CheckBlog.java, đối chiếu với đoạn code đã đăng. Đây là kiểm tra kết quả bằng Java, không phải benchmark JVM.
Bản sửa xử lý n <= 1 trước rồi dùng i <= n. Nếu đo tốc độ hai đoạn đó, còn phải bỏ System.out.print trong thân vòng lặp, để tránh so cả thời gian xuất dữ liệu với thời gian chỉ tính toán.
Đệ quy và cách viết công thức toán học
Định nghĩa giai thừa thường viết:
\[{0!} = 1,\qquad n! = n \times (n-1)!\]
Đọc là: giai thừa của không bằng một; với n nguyên dương, giai thừa của n bằng n nhân giai thừa của n trừ một. Ta mô tả trường hợp lớn bằng cùng một phép tính ở trường hợp nhỏ hơn.
Trong bài báo Lisp năm 1960, John McCarthy trình bày cách dùng biểu thức điều kiện để định nghĩa một hàm bằng công thức có chứa chính hàm ấy. Ông minh họa bằng giai thừa, ước chung lớn nhất và phép lặp tìm căn bậc hai. [6]


Trích đoạn dàn lại từ mục Recursive Function Definitions. Phần vàng nói về định nghĩa hàm, chưa quy định compiler phải tổ chức stack như thế nào.
Khi chứng minh bằng quy nạp, ta xử lý trường hợp cơ sở, giả sử kết quả đúng ở trường hợp nhỏ hơn, rồi dùng giả thiết ấy cho bước tiếp theo. Khi viết một hàm đệ quy, ta cũng có thể suy nghĩ ở mức đó: nếu lời gọi con trả đúng kết quả thì phải ghép ra sao để lời gọi hiện tại đúng, và điều gì bảo đảm cuối cùng sẽ chạm trường hợp cơ sở.
Tuy nhiên, nhu cầu lập trình của nhóm phát triển Lisp còn gồm xử lý các biểu thức ký hiệu để hệ thống có thể suy luận. Một biểu thức có thể chứa các biểu thức con; danh sách và cây cũng có cấu trúc lồng nhau. Đệ quy cho phép mô tả trực tiếp cách đi qua những cấu trúc ấy. Phần giới thiệu của McCarthy gắn hình thức toán học với nhu cầu xử lý biểu thức này. [6]
Vì vậy, tư duy toán học là một nguồn gốc quan trọng của cách diễn đạt đệ quy. Việc dùng nó trong chương trình còn phụ thuộc cấu trúc bài toán. Công thức Fibonacci xác định quan hệ giữa các số, nhưng người viết chương trình vẫn phải chọn có lưu kết quả trung gian hay không, tính từ dưới lên hay gọi từ trên xuống.
Quay lại mảng [1, 2, 3, 4], trạng thái của vòng lặp có thể viết thành một cặp gồm vị trí đang đọc và tổng hiện tại:
(vị trí, tổng)
(0, 0) -> (1, 1) -> (2, 3) -> (3, 6) -> (4, 10)
Một hàm tail recursion truyền cặp trạng thái kế tiếp sang lời gọi mới cũng mô tả được quá trình ấy. Ở phép thử C++, compiler chuyển nó thành vòng lặp. Ở phép thử Python, runtime vẫn thực hiện các lời gọi.
Đào sâu: mỗi lần gọi giữ những gì trên stack?
Khẳng định mỗi lần đệ quy đều lưu toàn bộ biến cục bộ là quá rộng. Compiler quyết định biến nào có thể bỏ, biến nào giữ trong thanh ghi và phần trạng thái nào cần bảo toàn qua lời gọi. AAPCS64 phân biệt các thanh ghi truyền tham số, thanh ghi mà hàm được gọi phải giữ nguyên, frame pointer và link register. [7]
Trong hai bản giữ lời gọi của benchmark, assembly cho thấy cách dùng stack cụ thể:
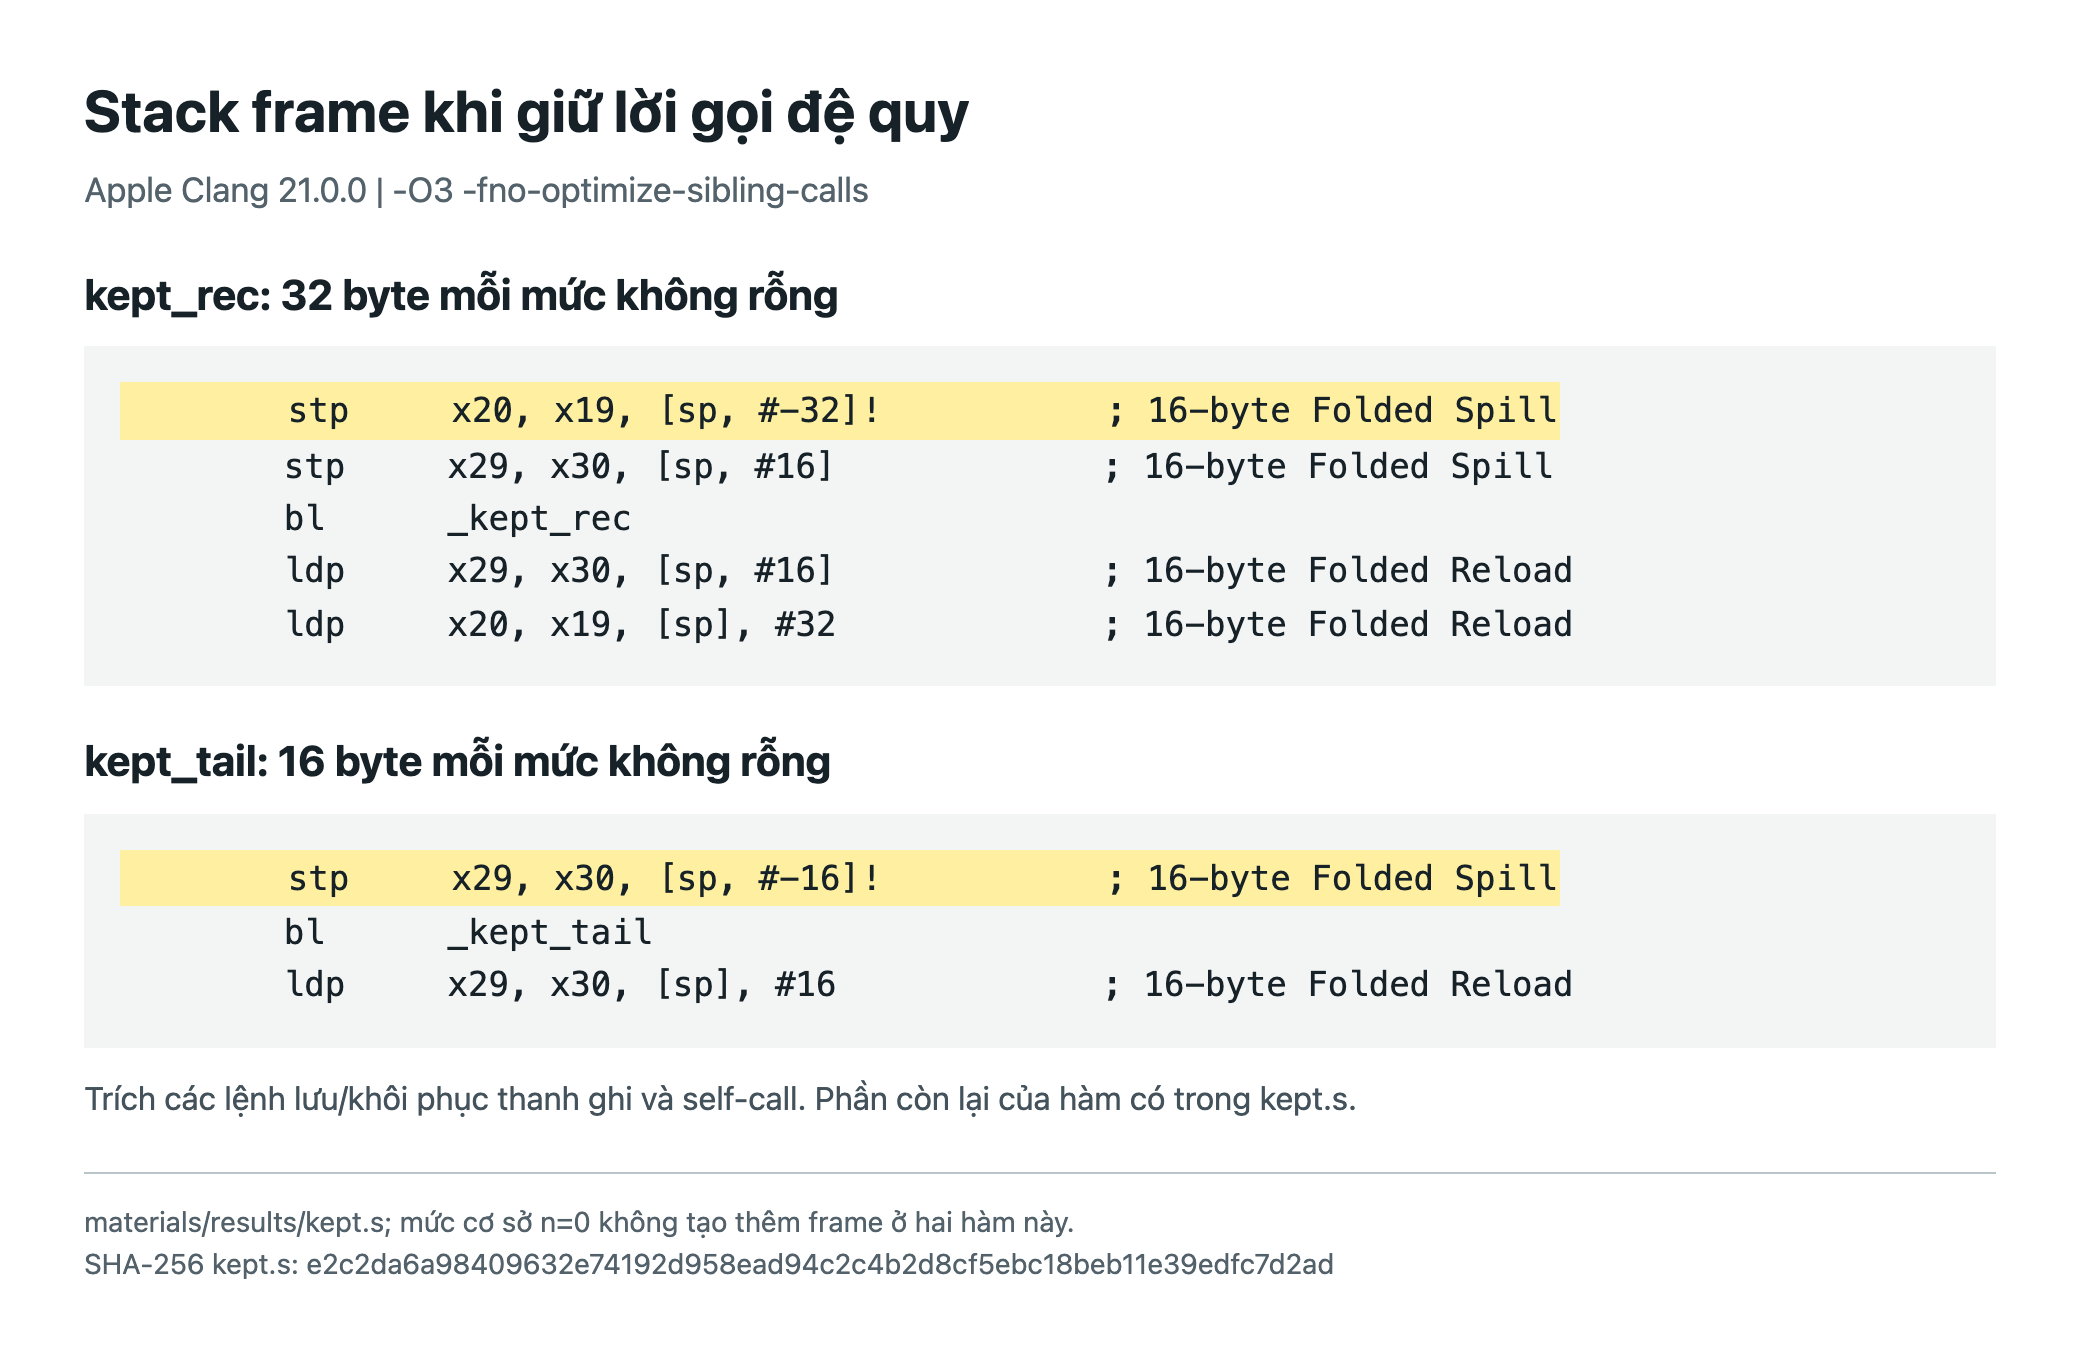

Các lệnh trích từ kept.s. Vùng vàng là bước giảm stack pointer; phía dưới mỗi đoạn có lệnh khôi phục tương ứng.
kept_rec dành 32 byte cho mỗi mức n > 0; kept_tail dành 16 byte. Với 4.096 phần tử, riêng chuỗi frame này tương ứng 128 KiB và 64 KiB. Trường hợp cơ sở n = 0 của hai hàm không tạo thêm frame. Đây là cách compiler đã tổ chức hai hàm cụ thể, không phải kích thước cố định cho mọi lần đệ quy.
Trong bản -O3 mặc định, Clang loại bỏ self-call nên không còn chuỗi frame tăng theo số phần tử. Nó có thể làm vậy với phép cộng uint32_t vì phép cộng modulo \({2^{32}}\) cho phép sắp lại các phép cộng mà vẫn giữ kết quả. Hàm có side effect, công việc phụ thuộc thứ tự, hoặc phép toán không cho phép biến đổi tương đương có thể giữ lại đệ quy. [3] [4]
Đào sâu: chạy lại và kiểm tra phép đo
Mã nguồn, dữ liệu thô và assembly của benchmark đi kèm để chạy lại. Trong thư mục vừa giải nén:
python3 run_native.py
python3 run_python.py
java CheckBlog.java
Script native dành cho Clang trên AArch64; bước kiểm assembly tìm cú pháp lệnh Arm của môi trường đã đo. Python dùng thư viện chuẩn. Chạy lại sẽ thay các file kết quả trong thư mục giải nén, nên giữ một bản dữ liệu gốc nếu muốn so hai lần đo.
Các kernel C++ nằm trong translation unit riêng với vòng đo, không bật LTO và có thuộc tính noinline. Vòng đo dùng kết quả để tạo checksum rồi kiểm checksum sau mỗi batch; compiler không được bỏ các lượt gọi chỉ vì chương trình không cần đáp án.
Bộ native giữ 456 mẫu trên sáu độ dài mảng. Hai bản còn self-call chỉ chạy đến 16.384 phần tử. Bộ kiểm tra đối chiếu 22.092 trường hợp, gồm các độ dài ngắn, vị trí bắt đầu lệch nhau và tổng tràn unsigned; lượt kiểm ASan/UBSan cũng trả PASS. Bộ Python cuối cùng có 132 mẫu. Dữ liệu của lượt khám phá đầu tiên nằm riêng trong các file python-initial*, không trộn vào bảng của lượt cuối.
Tất cả thời gian ở trên là warm-input microbenchmark trên macOS 26.5.2. Phép đo không ghim core, không cố định xung và không thu hardware counters. Mỗi nhóm có 12 mẫu với thứ tự đo xoay vòng; không loại mẫu chậm. Cấp phát dữ liệu nằm ngoài vùng tính giờ. Python tắt cyclic GC khi đo, còn bản memoization vẫn tính thời gian xóa cache và xây lại cache trong mỗi lượt.
Ảnh kết quả dựng từ CSV; ảnh compiler giữ nội dung log và assembly. Các ảnh tài liệu dàn lại đoạn trích, giữ nguyên lời nguồn và thêm highlight vàng. File evidence-manifest.json cùng script render_evidence.py ghi nguồn của từng ảnh để đối chiếu.
Với phép cộng mảng này, vòng for vẫn là lựa chọn ngắn và dễ đọc. Ở C++, compiler đã tạo SIMD mà không cần viết thêm intrinsics. Với Python, vòng lặp cũng tránh được giới hạn độ sâu đã gặp khi tăng mảng lên 1.500 phần tử.
Bình
Phụ lục: Citations (7)
- Nguyễn Anh Bình. Đệ Quy Khiến Bạn Trở Thành Kỹ Sư Tồi. Đối tượng kiểm tra lập luận và đoạn Java; không dùng làm nguồn xác nhận performance.
- Nguyễn Anh Bình. Cùng O(n), vì sao thời gian chạy khác nhau?. Nguồn gốc câu hỏi về compiler và SIMD; không lấy số benchmark cũ làm số mới.
- LLVM Analysis and Transform Passes: Tail Call Elimination. LLVM Project. Self-recursion thành loop và biến đổi accumulator cho một số biểu thức kết hợp.
- Auto-Vectorization in LLVM: Reductions. LLVM Project. Reduction, vector accumulators và giới hạn khi đổi thứ tự floating-point.
- What's new in Python 3.14: A new type of interpreter. Python Software Foundation. Phân biệt tail-call interpreter với TCO cho hàm Python, hiện chưa triển khai trong CPython.
- John McCarthy. Recursive Functions of Symbolic Expressions and Their Computation by Machine, Part I. Communications of the ACM. 1960-04-01. Đã đọc Introduction và Functions and Function Definitions; ví dụ giai thừa, mục tiêu xử lý biểu thức ký hiệu.
- Procedure Call Standard for the Arm 64-bit Architecture (AAPCS64). Arm. Vai trò các thanh ghi, r19-r29 callee-saved, r29 frame pointer, r30 link register; số byte frame lấy từ assembly local.