Cùng O(n), vì sao thời gian chạy khác nhau?
Giải thích SIMD, compiler và cache qua bốn cách tính tổng một mảng, kèm benchmark trên Apple M4 Pro và mã nguồn để chạy lại.
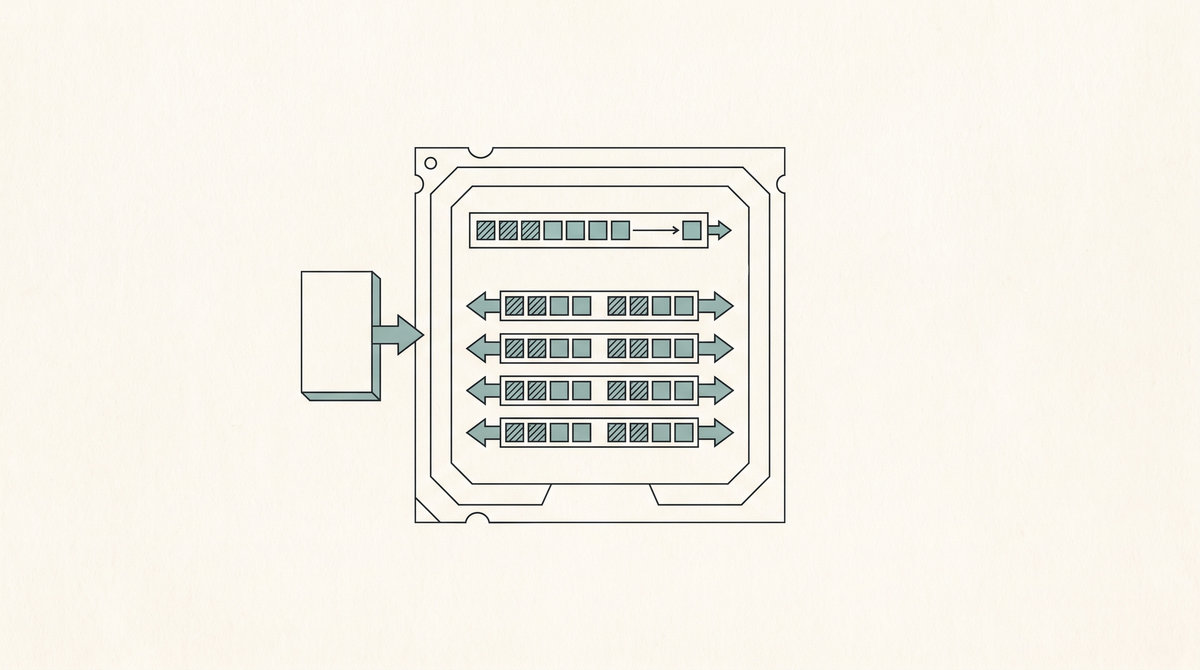
Hàm tính tổng một mảng số nguyên thường chỉ cần một vòng lặp:
uint32_t sum(const uint32_t *a, size_t n) {
    uint32_t s = 0;
    for (size_t i = 0; i < n; ++i) {
        s += a[i];
    }
    return s;
}
Hàm đọc hết \(n\) phần tử, cộng từng số vào s rồi trả về tổng. Nếu đề bài hỏi độ phức tạp thời gian, trả lời \(O(n)\) là đúng.
Nhưng cùng đoạn code ấy, hai cách biên dịch cho thời gian chạy khác nhau. Phép đo ngày 03/10/2026 trên Apple M4 Pro, với mảng 1 MiB, cho khoảng 63 microsecond khi tắt khả năng tự vectorize của Clang và khoảng 9,2 microsecond khi để compiler tự tối ưu với -O3. Cả hai đều chạy một thread, đọc cùng dữ liệu và trả cùng kết quả.
Bản tắt vectorization là đối chứng được tạo có chủ đích để so sánh, không phải cách biên dịch thường dùng khi muốn chương trình chạy nhanh. Phép so này giúp xem những thay đổi ở mã máy ảnh hưởng thế nào, dù số phần tử cần đọc vẫn như cũ.
O(n) cho biết lượng công việc tăng ra sao
Muốn tính tổng một mảng bất kỳ, chương trình phải đọc đủ các phần tử. Nếu bỏ qua một vị trí, thay số ở vị trí ấy sẽ làm tổng thay đổi mà chương trình không biết. Mảng dài gấp đôi thì số phần tử phải đọc cũng gấp đôi.
Khi phân tích độ phức tạp, ta xem lượng công việc tăng theo kích thước đầu vào như thế nào. Big-O cho một cận trên của tốc độ tăng đó; các hệ số nhân cố định không làm đổi bậc. Chẳng hạn, \({3n+10}\) và \({20n+100}\) đều thuộc \(O(n)\), dù với cùng một \(n\), lượng công việc tính ra khác nhau. [1]
Phép cộng mảng này có cả cận trên lẫn cận dưới tuyến tính, nên ký hiệu chặt hơn là \(\Theta(n)\). Dùng \(O(n)\) vẫn đúng, nhưng chưa cho biết hàm chạy trong bao nhiêu microsecond.
CPU thực thi mã máy sau khi biên dịch. Compiler có thể gom nhiều lượt của vòng for thành một lượt xử lý, dùng một lệnh máy để cộng nhiều cặp số cùng lúc. Cách thực hiện cùng một phép toán trên nhiều phần tử như vậy gọi là SIMD, viết đầy đủ là Single Instruction, Multiple Data.
CPU cộng bốn cặp số cùng lúc
Để dễ tính tay, dùng mảng gồm các số từ 1 đến 12. Dữ liệu benchmark là mảng sinh giả ngẫu nhiên; chương trình vẫn phải đọc từng phần tử, không dùng công thức tính tổng dãy số.
Nếu cộng lần lượt, biến s sẽ nhận các tổng 1, 3, 6, 10, rồi tiếp tục đến 78. Mỗi lần cộng phải dùng kết quả vừa tính xong.
Một thanh ghi vector 128 bit của Neon trên Arm có thể chứa bốn số nguyên 32 bit. Mỗi vị trí chứa một số gọi là một lane. Khi cộng hai vector, CPU cộng các số ở vị trí tương ứng, cho ra bốn kết quả riêng. Theo tài liệu Arm, intrinsic vaddq_u32 tương ứng với lệnh máy ADD thực hiện bốn phép cộng ấy. [2]
Ban đầu, bốn vị trí trong vector đều chứa số 0. CPU lần lượt nạp nhóm từ 1 đến 4, nhóm từ 5 đến 8 rồi nhóm từ 9 đến 12, cộng từng nhóm vào bốn tổng đang lưu.
CPU đọc đủ mười hai số và cộng dồn vào bốn tổng riêng. Bước cuối, cộng bốn kết quả thành tổng của cả mảng, gọi là horizontal reduction.
SIMD vẫn thực thi trong một thread, trên core đang chạy thread ấy. Các phép cộng xử lý số trong thanh ghi; không cần tạo bốn thread hay chia việc ra bốn core.
Nếu mảng có thêm phần tử thứ mười ba, phần dư ấy có thể cộng riêng bằng scalar. Mỗi vector chứa bốn phần tử nên số nhóm, tính cả nhóm cuối có thể thiếu phần tử, là \(\lceil n/4\rceil\). Tăng \(n\) gấp đôi vẫn làm số nhóm tăng gần gấp đôi: cách xử lý này cũng có bậc tuyến tính.
Bốn lane chưa bảo đảm nhanh gấp bốn. CPU còn phải nạp dữ liệu, gộp các tổng và xử lý phần dư. Hơn nữa, ngay cả với lệnh scalar, CPU cũng có thể xử lý nhiều lệnh độc lập chồng lấp nhau.
Tách một tổng thành bốn tổng riêng
Phép cộng scalar trong vòng lặp ban đầu là:
s += a[i];
Lượt sau phải chờ kết quả s của lượt trước. Dù CPU còn khả năng thực thi các lệnh khác, nó cũng không thể tính trước một phép cộng khi chưa có đủ dữ liệu.
Tách thành s0, s1, s2, s3 sẽ tạo bốn chuỗi tính toán độc lập:
s0 += a[i];
s1 += a[i + 1];
s2 += a[i + 2];
s3 += a[i + 3];
Phép cộng vào s1 không cần chờ kết quả mới của s0, nên CPU có thêm cơ hội xử lý chúng cùng lúc. Nếu gom nhiều phần tử vào một lượt lặp, ta còn giảm được số lần cập nhật chỉ số và kiểm tra điều kiện kết thúc. Việc mở rộng thân vòng lặp như vậy gọi là loop unrolling.
Để phân biệt phần cải thiện này với SIMD, bộ benchmark có thêm một bản scalar unrolled: bốn biến tích luỹ, 16 phần tử mỗi lượt, vẫn tắt vectorization. Đo bốn phiên bản trên cùng mảng 1 MiB cho kết quả:
| Cách thực hiện | Thời gian một lượt cộng toàn mảng |
|---|---|
| Scalar đơn giản, tắt vectorization | 63,0 microsecond |
| Scalar unrolled, vẫn tắt vectorization | 15,3 microsecond |
Vòng for ban đầu, compiler tự vectorize |
9,2 microsecond |
| Neon viết tay | 9,3 microsecond |
Mỗi con số là median, tức trung vị, của 12 mẫu đo. Một mẫu gồm nhiều lượt chạy trên cùng mảng sau một lượt làm nóng. Cấp phát và khởi tạo dữ liệu không tính vào thời gian chạy. Cả bốn bản đều dùng Apple Clang 21.0.0 với -O3.
Bản scalar unrolled nhanh hơn bản scalar đơn giản khoảng bốn lần, dù chưa dùng phép cộng vector. So với bản unrolled, bản compiler tự vectorize nhanh hơn khoảng 1,7 lần. Vì vậy, không thể quy toàn bộ chênh lệch từ 63 xuống 9,2 microsecond cho riêng SIMD.
Compiler còn có thể sắp lại phép cộng và thay cách dùng thanh ghi. Phép so trên cho thấy tác dụng của việc tổ chức lại vòng lặp, chứ chưa đo riêng từng thay đổi ở cấp lệnh máy.
Compiler có thể tự tạo mã SIMD
Hai kết quả 9,2 và 9,3 microsecond gần nhau hơn mức dao động giữa các mẫu. Bản Neon viết tay chưa cho thấy lợi ích thêm so với vòng for để compiler tự tối ưu.
LLVM có bước tối ưu Loop Vectorizer để chuyển những vòng lặp phù hợp sang mã vector. Compiler nhận diện phép tính tổng là một dạng reduction, tách biến tổng thành các tổng riêng rồi gộp lại sau vòng lặp. [3]
Khi biên dịch vòng for trên máy đo, Clang ghi:
vectorized loop (vectorization width: 4, interleaved count: 4)
width: 4 là bốn phần tử trong một vector; interleaved count: 4 là bốn nhóm vector trong thân vòng lặp. Assembly xác nhận mỗi lượt chính xử lý 16 phần tử, dùng bốn vector tích luỹ độc lập. Compiler đã kết hợp vectorization với cách tách tổng vừa thử ở bản scalar.

Trích đoạn được dàn lại từ mục Reductions của tài liệu LLVM; phần tô vàng giữ nguyên lời nguồn.
Nhìn vào mã nguồn, vòng for này vẫn cộng từng phần tử. Muốn biết CPU có dùng SIMD hay không, cần xem mã máy hoặc thông báo tối ưu của compiler.
Code dùng intrinsics Neon còn gắn với kiến trúc Arm. Để viết SIMD cho nhiều nền tảng, lập trình viên phải tính tới khác biệt về độ rộng vector và những lệnh mỗi CPU hỗ trợ. Nhóm Go giới thiệu một API thử nghiệm cho việc này vào ngày 24/9/2026. [4] Đây là thông tin về thiết kế API; các số đo ở đây vẫn chỉ thuộc phép thử C/Clang/Neon.
Kết quả khi tăng kích thước mảng
Giữ nguyên code, tăng mảng từ 1 MiB lên 256 MiB rồi chia thời gian chạy cho số phần tử để so sánh.
Với bản compiler tự vectorize, kết quả là khoảng 0,035 nanosecond/phần tử ở mảng 1 MiB và 0,053 nanosecond/phần tử ở mảng 256 MiB, tăng khoảng 51%. Cách tính này lấy thời gian của nhiều lượt chạy chia cho tổng số phần tử đã xử lý. Nó đo tốc độ xử lý bình quân, không đo độ trễ của một phép cộng riêng lẻ.
CPU có thể đọc lại dữ liệu vừa dùng từ cache, nhanh hơn lấy từ RAM. Cache lưu dữ liệu theo từng khối gọi là cache line. Khi chương trình đọc một phần tử, các phần tử nằm cạnh nó trong cùng khối cũng có thể đã được nạp vào cache, nên cách duyệt mảng tuần tự thường có lợi. [5]
Mảng nhỏ được đọc đi đọc lại có nhiều cơ hội nằm sẵn trong cache. Khi vùng dữ liệu đang dùng, hay working set, lớn lên, lợi thế này có thể giảm. Dù CPU cộng nhanh hơn nhờ SIMD, nó vẫn cần nhận đủ dữ liệu trước khi tính.
Mảng uint32_t có \(n\) phần tử chiếm \({4n}\) byte. Gọi \(B\) là số byte dữ liệu hữu ích cung cấp cho phép duyệt trong một giây, ta ước lượng thời gian cung cấp dữ liệu là:
\[T_{\text{data}} \approx \frac{4n}{B}\]
\(B\) phải lấy từ phép đo phù hợp. Băng thông RAM trên bảng thông số là chưa đủ: dữ liệu có thể đến từ cache, còn một thread chưa chắc sử dụng hết băng thông của máy. Chương trình chạy cùng lúc cũng có thể tranh chấp tài nguyên.
Các mẫu đo có lần chậm bất thường, nhất là với mảng lớn. Phép thử không cố định core hay xung CPU và không thu các bộ đếm hiệu năng của phần cứng. Ta quan sát được thời gian trên mỗi phần tử tăng theo kích thước mảng, nhưng chưa đo được tỷ lệ cache miss hoặc xác định lúc nào DRAM hết băng thông. Vì thế, không nên dùng biểu đồ này để kết luận mọi phần chậm thêm đều do cache.
Đào sâu: so sánh mã máy của hai phiên bản
Bản scalar bị tắt vectorization có thân vòng lặp sau:
ldr  w9, [x0], #4
add  w8, w9, w8
subs x1, x1, #1
b.ne loop
ldr đọc một số 32 bit rồi tăng địa chỉ lên bốn byte. add cộng số vừa đọc vào tổng trong w8; hai lệnh còn lại giảm bộ đếm và lặp tiếp khi chưa hết. Nhãn loop là tên rút gọn của nhãn do compiler sinh ra.
Trong bản compiler tự vectorize, thân vòng lặp chính là:
ldp    q4, q5, [x8, #-32]
ldp    q6, q7, [x8], #64
add.4s v0, v4, v0
add.4s v1, v5, v1
add.4s v2, v6, v2
add.4s v3, v7, v3
subs   x10, x10, #16
b.ne   loop
Hai lệnh ldp nạp bốn vector 128 bit, tổng cộng 64 byte hay 16 số uint32_t. Mỗi add.4s cộng bốn cặp số 32 bit. Các thanh ghi v0 đến v3 giữ bốn vector tích luỹ độc lập.
Sau vòng lặp chính còn phần gộp các vector tích luỹ, cộng các số trong vector bằng addv.4s và xử lý phần tử dư. Đếm lệnh trong thân vòng lặp thôi sẽ bỏ sót các bước ấy; với mảng rất ngắn, chúng có thể chiếm phần đáng kể của thời gian chạy.
Phép thử dùng uint32_t, kiểu số nguyên không dấu 32 bit. Phép cộng kiểu này lấy kết quả modulo \({2}^{32}\) khi vượt phạm vi, nên đổi thứ tự cộng vẫn cho cùng kết quả. Mảng benchmark chứa các số từ 0 đến 15; ngay ở kích thước lớn nhất, tổng vẫn chưa vượt phạm vi. Bộ kiểm tra riêng có thêm dữ liệu để kiểm cả trường hợp vượt phạm vi ấy.
Với float, đổi thứ tự cộng có thể làm đổi kết quả do làm tròn. Compiler phải tuân thủ các yêu cầu về kết quả phép tính; LLVM xử lý riêng trường hợp cần giữ thứ tự và trường hợp cho phép sắp lại các phép cộng. [3]
Đào sâu: chạy lại phép đo
Bộ benchmark đi kèm chứa mã nguồn, script chạy và mẫu đo thô. Trên máy AArch64 có Clang, Neon và Python 3, giải nén rồi chạy:
python3 run.py
Script biên dịch từng phiên bản thành object file riêng và không bật link-time optimization. Hai bản scalar thêm -fno-vectorize -fno-slp-vectorize; bản tự vectorize dùng chính sum.c với -O3. Vòng đo bên ngoài ghi kết quả vào một biến volatile để tránh compiler bỏ các lượt gọi vì kết quả không được dùng.
Mảng lớn nhất chiếm 256 MiB. Mỗi phiên bản có 12 mẫu ở từng kích thước, với thứ tự xoay vòng để các bản lần lượt được đo trước. Mỗi mẫu bắt đầu bằng một lượt đọc làm nóng, sau đó chạy nhiều lượt trên cùng mảng. Cách đo này cho phép tái sử dụng cache, không đo trường hợp dữ liệu hoàn toàn vắng khỏi cache (cold cache).
Trước khi đo, chương trình thử 1.032 cặp độ dài và vị trí bắt đầu đọc cho mỗi phiên bản. Các trường hợp gồm mảng rỗng, phần tử dư và dữ liệu có tổng vượt phạm vi số nguyên 32 bit. Bộ kiểm tra cũng đã chạy qua AddressSanitizer và UndefinedBehaviorSanitizer.
Thư mục results/ chứa các file raw.csv, summary.json, metadata.json cùng assembly. Script giữ lại kết quả cũ mỗi lần chạy lại. Khi thử trên máy khác, nên đối chiếu cả kết quả lẫn mã máy: cùng cờ compiler vẫn có thể tạo ra các lệnh khác nhau.
Hàm sum vẫn cần đọc hết mảng, nên dùng SIMD không đổi được bậc tuyến tính. Tuy vậy, cách tổ chức các phép cộng và nạp dữ liệu đã làm thời gian chạy khác nhau đáng kể.
Với phép thử này, bản Neon viết tay chạy gần bằng vòng for ban đầu khi bật tối ưu. Có thể giữ hàm ngắn, dễ đọc ấy mà vẫn có SIMD. Trước khi viết thêm code tối ưu, việc đáng làm là kiểm tra compiler đã tạo ra những lệnh gì.
Phụ lục: Citations (5)
- Dictionary of Algorithms and Data Structures: big-O notation. NIST. Định nghĩa cận trên tiệm cận. Với phép duyệt toàn bộ mảng trong ví dụ, Theta(n) là mô tả chặt hơn.
- Arm Neon Intrinsics Reference. Arm. vaddq_u32 ánh xạ sang ADD Vd.4S,Vn.4S,Vm.4S; vaddvq_u32 ánh xạ sang ADDV để cộng các lane.
- Auto-Vectorization in LLVM. LLVM Project. Loop Vectorizer, reduction, cost model, vectorizer remarks và các giới hạn khi đổi thứ tự floating-point operations.
- David Chase and Junyang Shao. Platform-independent SIMD in Go. The Go Project. 2026-09-24. Nguồn thời sự gợi đề tài. API SIMD còn experimental; khác biệt vector size và masking giữa các kiến trúc. Benchmark đi kèm bài dùng C/Clang/Neon, không dùng API Go này.
- CS 3410: Caches. Cornell University. Memory hierarchy, cache lines, temporal locality và spatial locality. Không phải thông số cache riêng của Apple M4 Pro.