Literature review: thiết kế harness để tìm research gap
Thiết kế ontology và harness cho literature review: lưu kết quả cùng điều kiện, truy về nguồn và kiểm tra research gap trước khi chọn đề tài.
Sau phần tìm và sàng lọc paper với PRISMA, mình còn một câu hỏi: có thể xây một harness để hỗ trợ tìm hướng nghiên cứu không? Nếu đưa các bài báo vào knowledge graph, nên tạo node và cạnh nào để viết literature review, rồi xác định research gap?
Mình muốn dùng công cụ đó để kiểm tra căn cứ trước khi nói một câu hỏi vẫn chưa có lời giải. Muốn vậy thì phải giữ được cả điều kiện thực nghiệm lẫn lịch sử tìm kiếm, mà một danh sách paper gần nhau về nội dung thì không nói được hai thứ đó.
60% của A và 60% của B không đo cùng một thứ
Lấy lại ví dụ giả định về AI agents làm pentest. Agent A giải được 18 trong 30 tác vụ CTF, với tối đa 10 lượt thử cho mỗi tác vụ và có người gợi ý khi mắc kẹt. Agent B thành công trên 12 trong 20 mục tiêu web ở lab, mỗi mục tiêu một lượt chạy, không có gợi ý trong lúc thực hiện.
Cả hai tỷ lệ đều bằng 60%. Nếu bảng dữ liệu chỉ có hai cột system và success_rate, người đọc sẽ coi chúng là hai phép đo tương đương, trong khi nhiệm vụ, số cơ hội thử và mức hỗ trợ đều khác nhau. Gộp thành 30/50 cũng chỉ giữ lại một tỷ lệ và bỏ mất đúng những khác biệt cần giải thích.

Hình 1. Số liệu minh họa. Hai Experiment giữ riêng số lượt thử và mức hỗ trợ, nên 18/30 và 12/20 không rơi về cùng một ô.
Một extractor có thể chép đúng từng con số mà vẫn khiến người review kết luận sai. Chỉ số ở bảng kết quả có thể là lần chạy tốt nhất, còn giới hạn số lần thử nằm trong phụ lục. Phần phương pháp có thể nói rõ người dùng được phép sửa lệnh, dù abstract mô tả hệ thống là tự chủ.
Vì vậy, đơn vị dữ liệu mình muốn lưu là một kết quả trong một thực nghiệm cụ thể. Khi đọc được số đo, công cụ còn phải tìm định nghĩa metric, nhiệm vụ, cấu hình hệ thống và điều kiện chạy. Trường nào chưa tìm được thì để trạng thái chưa có thông tin, thay vì đoán một giá trị cho đủ bảng.
Với ví dụ A/B, câu đúng phải là chưa đủ cơ sở kết luận hai hệ thống hiệu quả tương đương. Muốn hỏi kiến trúc nào tốt hơn, bạn cần một thiết kế so sánh khác.
Từ paper sang lập luận
Giả sử mình có một nhóm bài về planning, memory và multi-agent trong pentest. Nếu mỗi đoạn chỉ kể một paper dùng gì, phần review sẽ dài dần theo số bài đã đọc. Người đọc vẫn phải tự tìm xem các phương pháp liên quan với nhau thế nào.
Mình sẽ bắt đầu từ câu hỏi như: "Tác giả phân chia việc lập kế hoạch và thực thi ra sao?" hoặc "Người dùng can thiệp ở bước nào?". Một paper có thể đóng góp vào nhiều câu hỏi; một câu hỏi có thể cần đối chiếu nhiều paper. Khi đó, bảng trích xuất có thêm các cột về khái niệm, điều kiện, kết quả và vị trí nguồn, thay vì chỉ chứa tóm tắt từng bài.

Hình 2. Sơ đồ tổ chức nội dung đề xuất. Người review gom bằng chứng theo câu hỏi trước khi viết đoạn tổng hợp.
Cần tách kết quả quan sát được khỏi nhận định của tác giả. "Hoàn thành 18/30 tác vụ trong thiết lập E1" là kết quả cụ thể. "Cơ chế lập kế hoạch giúp hệ thống xử lý tác vụ dài tốt hơn" là một nhận định, và bạn cần xem thiết kế thực nghiệm có tách được tác động của cơ chế đó hay chưa. Nếu tác giả đồng thời đổi model, tăng ngân sách và thêm công cụ, phần cải thiện không quy được cho riêng planning.
Khi viết, mỗi đoạn nên trả lời một phần của RQ: nêu nhận định, dẫn các nghiên cứu liên quan, đối chiếu bằng chứng trái chiều, rồi giới hạn phạm vi kết luận. Không phải đoạn nào cũng cần đủ các thành phần theo một công thức cố định. Có câu hỏi chỉ mới có dữ liệu mô tả; có câu hỏi đủ điều kiện để tổng hợp định lượng.
PRISMA giúp tác giả báo cáo quá trình review minh bạch, và statement nói rõ nó không hướng dẫn cách tiến hành review cũng không chấm chất lượng phương pháp. Cách tổng hợp bằng chứng vẫn phải chọn theo câu hỏi và loại nghiên cứu. [1]
Những công trình đã đi trước
Ý tưởng tổ chức tri thức nghiên cứu thành graph đã có những hướng triển khai cụ thể. Open Research Knowledge Graph (ORKG) mô tả nội dung học thuật qua các thực thể và quan hệ, để truy vấn vấn đề nghiên cứu, phương pháp và dữ liệu đánh giá. Với bài toán này, ORKG là một điểm tham khảo cho cách biểu diễn đóng góp nghiên cứu. [2]
SciREX, công bố tại ACL 2020, tập trung vào trích xuất thông tin ở cấp tài liệu, trong đó có quan hệ nhiều thành phần. Điều này gần với khó khăn của ví dụ 60%: thông tin cần ghép có thể nằm qua nhiều câu hoặc nhiều phần của paper. SciREX cho mình một cách phát biểu bài toán, không cho sẵn bộ trích xuất dùng được cho pentest. [3]

Hình 3. Bốn công trình nằm ở bốn chỗ khác nhau của bài toán: biểu diễn, trích xuất, kiểm novelty và phát triển ý tưởng.
Ở phía phát triển ý tưởng, SciMON, ACL 2024, lấy cảm hứng từ tài liệu đã có và lặp lại việc so sánh đề xuất với nghiên cứu trước để cải thiện novelty. ResearchAgent, NAACL 2025, kết hợp academic graph với các khái niệm liên quan, rồi dùng vòng phản biện để phát triển vấn đề, phương pháp và thiết kế thực nghiệm. [4] [5]
Những công trình này đủ để mình tránh đặt đóng góp ở mức quá rộng như "dùng LLM và knowledge graph để tìm research gap". Câu hỏi hẹp hơn đáng thử là: lưu điều kiện thực nghiệm có giúp giảm những kết luận so sánh sai không? Nếu thêm nhật ký tìm kiếm và bước tìm bằng chứng phản bác, công cụ có bớt đề xuất các gap vốn đã có nghiên cứu trả lời không?
Khi chốt RQ, mình vẫn phải tìm các review và hệ thống gần nhất, đọc phạm vi, dữ liệu đánh giá và ngày tìm kiếm cuối của chúng.
Schema mọc ra từ câu hỏi tra cứu
Để chọn schema, mình cần biết người review sẽ tra cứu gì. Nhận định này dựa trên trang nào? Hai kết quả có cùng định nghĩa metric không? Bản preprint và bản hội nghị có đang báo cáo cùng một nghiên cứu? Nếu tác giả sửa bảng kết quả, những đoạn tổng hợp nào cần xét lại?
Các câu hỏi ấy quyết định ontology: loại đối tượng nào tồn tại, chúng liên hệ thế nào và một quan hệ mang nghĩa gì.
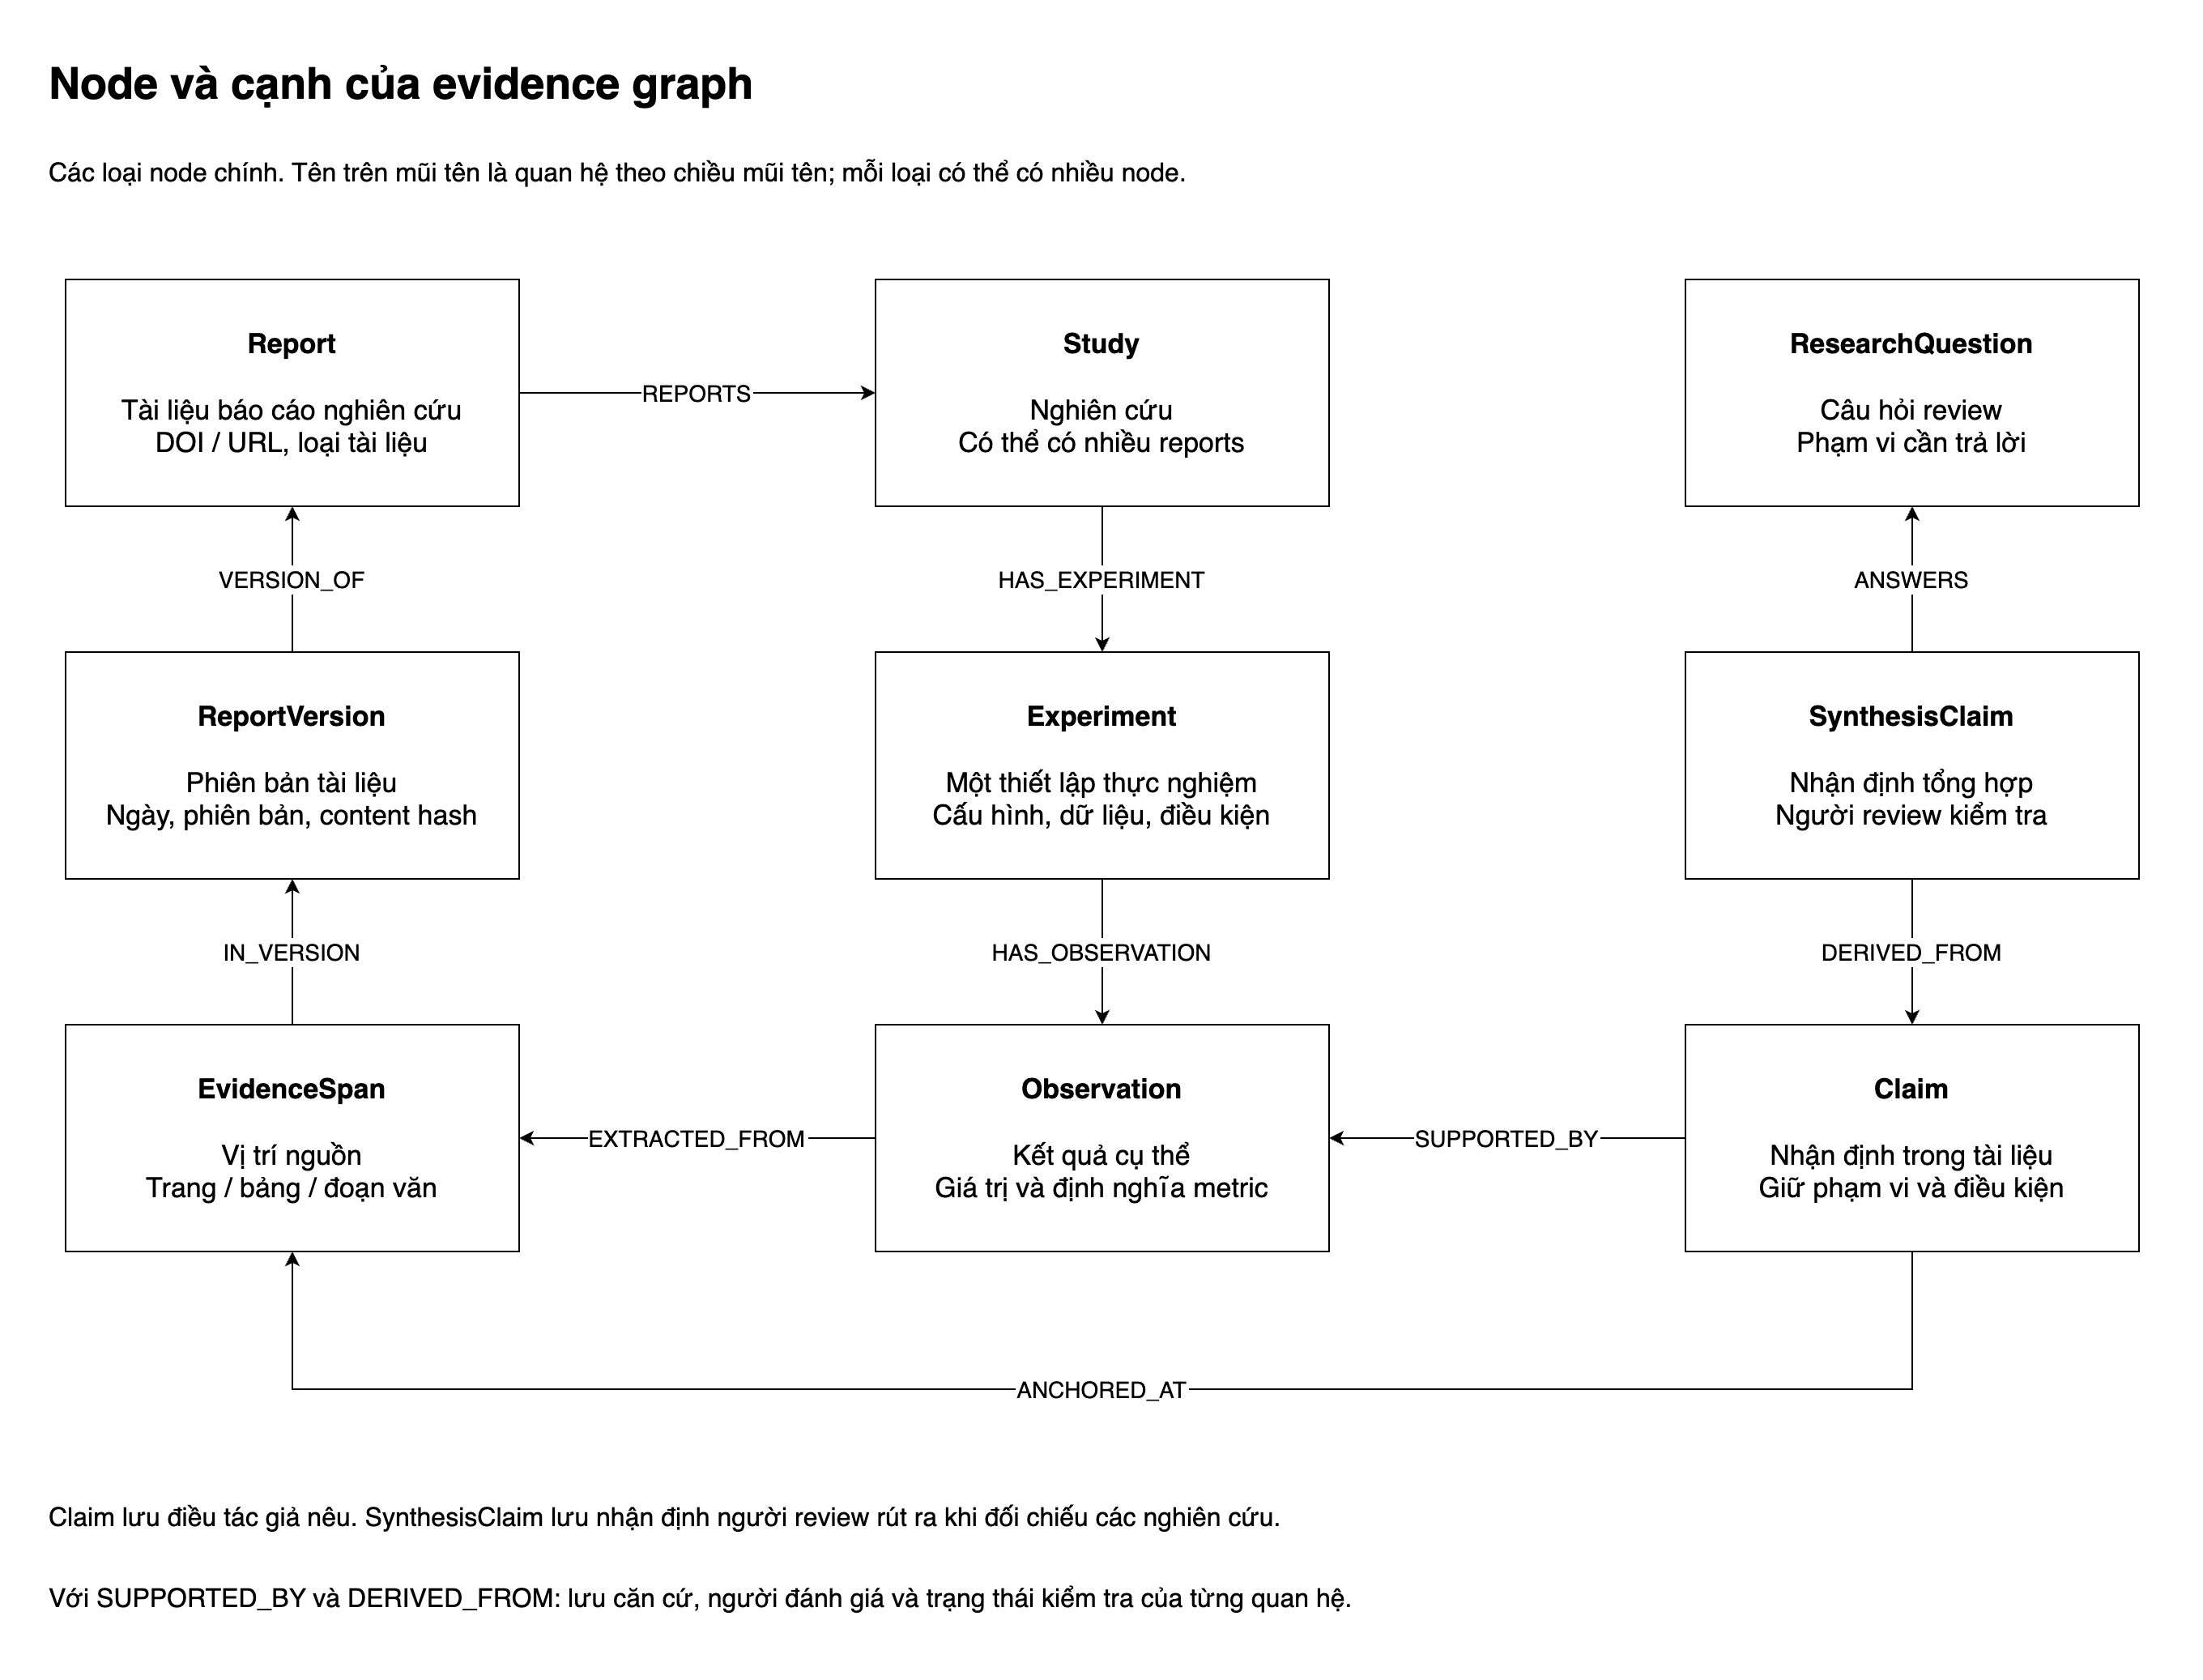
Hình 4. Mô hình lõi. Người review đi ngược từ một nhận định tổng hợp về kết quả, điều kiện thực nghiệm và phiên bản tài liệu chứa nguồn.
Report là tài liệu báo cáo; Study là nghiên cứu đứng sau tài liệu. Một study có thể có nhiều reports. Record là bản ghi mà một nguồn tìm kiếm trả về. PRISMA phân biệt các đơn vị này để tránh lẫn bản ghi trùng với nhiều tài liệu của cùng nghiên cứu. [1]
Mình bổ sung ReportVersion để giữ phiên bản nội dung. EvidenceSpan chỉ đến trang, bảng, đoạn hoặc ô dữ liệu của phiên bản đó. DOI giúp định danh tài liệu, nhưng không đủ để biết extractor đã đọc những bytes nào; content hash và ngày truy xuất giúp kiểm tra việc này.
Experiment chứa một thiết lập đánh giá. Khi cần truy vấn độc lập, mình nối nó với SystemConfiguration, Task, DatasetVersion và Context. Observation lưu kết quả, nối với MetricDefinition để giữ cả định nghĩa metric, đơn vị và cách tổng hợp. Những trường đơn giản như tử số hoặc mẫu số có thể là thuộc tính, không cần biến mỗi con số thành một node.
Claim lưu nhận định trong tài liệu. SynthesisClaim lưu nhận định người review rút ra khi đối chiếu các nghiên cứu. Một đoạn nguồn chứng minh tác giả đã nói điều gì; nó chưa chứng minh tác giả đã kết luận đúng. Vì thế, cần lưu riêng trạng thái kiểm tra trích xuất và đánh giá chất lượng bằng chứng.
Các cạnh như SUPPORTED_BY cũng cần căn cứ: ai đánh giá, dựa vào nguồn nào, đã duyệt hay còn tranh luận. Với hai kết quả khác dấu, trước tiên tạo một yêu cầu đối chiếu. Chỉ gắn quan hệ mâu thuẫn sau khi người review kiểm tra câu hỏi, điều kiện và ý nghĩa thống kê; "không có ý nghĩa thống kê" chưa đủ để kết luận "không có tác động".
Provenance là lịch sử nguồn gốc và xử lý dữ liệu. PROV-O cung cấp các khái niệm Entity, Activity, Agent cùng các quan hệ về sử dụng, tạo ra và dẫn xuất. Có thể dùng chúng để ghi từ phiên bản paper qua lần trích xuất đến sửa đổi của người review. [6]
Citation cũng cần ngữ nghĩa riêng. Paper A trích B có thể để dùng phương pháp, mở rộng kết quả hoặc phản đối. CiTO hỗ trợ mô tả mục đích trích dẫn; một cạnh CITES đơn thuần chưa cho biết bên trích có đồng ý hay không. [7]
Một ô trống có thể là lỗi thu thập
Giả sử graph chưa có quan hệ giữa một phương pháp và một benchmark. Có thể chưa ai đánh giá tổ hợp đó. Cũng có thể tác giả dùng tên viết tắt khác, bài nằm ngoài nguồn tìm kiếm, hoặc extractor bỏ sót thông tin trong phụ lục.
Trong OWL, giả định open-world cho phép một thông tin vắng mặt trong ontology vẫn có thể đúng. Thiếu một mệnh đề không đủ để suy ra phủ định của nó. Đây là giới hạn trực tiếp khi dùng graph để phát hiện gap. [8]

Hình 5. Một ô chưa có số liệu cần giữ lý do thiếu. Chỉ nhìn ô trống thì chưa xác định được loại research gap.
Ví dụ trường chi phí nên phân biệt not_extracted với not_reported. Trường hợp đầu cần đọc hoặc trích xuất tiếp; trường hợp sau cần căn cứ rằng tài liệu đã kiểm tra không báo cáo thông tin đó. unavailable dành cho nguồn chưa lấy được, còn not_applicable dành cho trường không áp dụng. Nếu tác giả ghi chi phí bằng 0 theo một định nghĩa cụ thể thì đó lại là một giá trị được báo cáo, không phải dữ liệu thiếu.
Khung của Robinson và cộng sự phân loại lý do tồn tại gap thành thông tin chưa đủ hoặc chưa chính xác, thông tin có sai lệch, kết quả chưa nhất quán, và thông tin chưa đúng với câu hỏi cần trả lời. Khung này xuất phát từ tổng hợp bằng chứng y tế; mình tham khảo cách đặt câu hỏi, không dùng nguyên công cụ đánh giá của y tế cho software engineering. [9]
Với review về agent, mình sẽ dùng các nhãn làm việc như thiếu thông tin báo cáo, thiếu cơ sở so sánh, kết quả trái chiều hoặc chưa rõ khả năng áp dụng sang môi trường khác. Một study có thể dính nhiều nhãn cùng lúc, và định nghĩa từng nhãn chắc chắn sẽ đổi sau vài chục paper đầu tiên.
Không nên lấy toàn bộ tích Method × Task × Dataset rồi coi mỗi ô trống là một đề tài. Nhiều tổ hợp không có ý nghĩa thực tế. Mật độ graph thấp còn phụ thuộc phạm vi corpus, cách tách khái niệm và chất lượng extraction. Nó có thể giúp ưu tiên chỗ cần đọc thêm, nhưng chưa đo được tầm quan trọng của một câu hỏi khoa học.
"Chưa có nghiên cứu nào" nghĩa là chưa tìm thấy
Một gap ứng viên phải đi cùng phạm vi tìm kiếm. Thay vì viết "chưa có nghiên cứu về chi phí của pentest agents", mình ghi: "Trong tập nghiên cứu đã chọn, thông tin hiện có chưa đủ để so sánh các kiến trúc dưới cùng ngân sách". Câu sau dài hơn, nhưng nó nói rõ mình đang đứng trên tập bằng chứng nào.
Mình sẽ tạo GapCandidate với câu hỏi, loại thiếu hụt, các nghiên cứu liên quan và CorpusSnapshot. Snapshot giữ danh sách tài liệu, tiêu chí, nguồn tìm, query và thời điểm. Nếu còn thiếu toàn văn, hồ sơ cần ghi phần đó để người review biết kết luận đang dựa trên dữ liệu chưa đầy đủ.

Hình 6. Gap ứng viên có thể bị sửa hoặc loại sau khi tìm thêm tài liệu. Chưa tìm thấy lời giải trong phạm vi đã tìm vẫn cần người review đánh giá.
Bước tiếp theo là đi tìm những công trình có khả năng làm đề xuất của mình sai. Nếu mình nghi là thiếu phép so sánh cùng ngân sách, mình tìm quanh controlled evaluation, ablation, cost-aware hoặc budget-matched, rồi mở từng bài ra xem nội dung có đúng thế không.
Tìm lại được các seed papers chỉ xác nhận truy vấn không bỏ sót nhóm bài đã biết. Số đó không cho biết có bao nhiêu nghiên cứu liên quan ngoài corpus. Khi một ứng viên có vẻ đáng theo đuổi, người review còn phải xét các nguồn chưa tìm, những tên gọi khác và lý do loại bài trước đó.
Một hồ sơ rút gọn trông như sau:
id: gap-example-01
type: comparability_gap
status: proposed
question: "Kiến trúc nào hiệu quả hơn dưới cùng ngân sách?"
corpus_snapshot: corpus-example-v1
supporting_assessments: [comparison-example-01]
counterevidence_searches: []
unresolved_fulltexts: []
reviewer_decision: pending
Danh sách tìm kiếm phản bác đang trống, nên hồ sơ này chưa đủ để xác nhận gap. Mỗi trạng thái phải có định nghĩa viết sẵn, để pending trong đầu mình và pending trong code là cùng một thứ.
Nếu giữ ứng viên, cần nêu nghiên cứu nào có thể trả lời nó. Với câu hỏi về kiến trúc agent, một phương án là giữ model, benchmark, ngân sách và mức hỗ trợ tương đương, đồng thời báo cáo các lần chạy theo protocol đã chốt. Kết quả có thể cho thấy lợi ích của kiến trúc vẫn còn, giảm đi hoặc phụ thuộc loại nhiệm vụ. Cả ba khả năng đều giúp trả lời câu hỏi, miễn là thiết kế đủ sức phân biệt chúng.
Một lần chạy để lại gì ngoài đoạn chat cuối
Ở đây, harness là phần điều phối công việc quanh LLM: công cụ tìm kiếm, kho tài liệu, schema, trạng thái xử lý và các bước kiểm tra. Một tháng sau, mình phải mở lại được tài liệu nào đã đọc, model đã trích gì ra khỏi chúng, và chính mình đã sửa tay ở chỗ nào.

Hình 7. Mỗi bước giữ input, output và phiên bản. Người review duyệt những quyết định ảnh hưởng đến tập bằng chứng và kết luận.
LLM có thể gợi ý từ đồng nghĩa, chuẩn hóa metadata và tạo nháp extraction. Khi thiếu đoạn nguồn hoặc có hai cách hiểu về một kết quả, harness nên đưa trường đó vào danh sách cần kiểm tra. LLM chạy lần thứ hai có thể hỗ trợ phát hiện lỗi, nhưng không nên tính nó thành một reviewer độc lập của con người.
Một số ràng buộc cần thực thi bằng code: không đưa dữ kiện chưa có nguồn vào tập đã duyệt; không gộp study chỉ dựa trên embedding; không tự thay dữ liệu thiếu bằng 0. Các quyết định như có đủ cơ sở so sánh hay nghiên cứu gốc có nguy cơ sai lệch gì cần hướng dẫn đánh giá và người chịu trách nhiệm. Model confidence đo điều khác với độ chắc chắn của bằng chứng khoa học.
Tài liệu đầu vào cũng chỉ là dữ liệu. Một paper có thể chứa ví dụ prompt, lệnh shell hoặc câu yêu cầu mô hình bỏ qua chỉ dẫn trước. Harness không được thực thi các câu đó như lệnh vận hành của mình. Công cụ tìm kiếm và quyền ghi dữ liệu nên có phạm vi rõ ràng, tách khỏi nội dung đang đọc.
Khi có bản paper mới, mình muốn giữ bản cũ, ghi quan hệ phiên bản rồi đánh dấu các extraction phụ thuộc cần xét lại. Nếu một Observation đổi, mình phải biết ngay SynthesisClaim và GapCandidate nào đã dựa vào nó. Đây là chỗ graph có cơ hội thắng bảng, vì truy vấn đi nhiều bước.
Đến bước viết, người viết hoặc LLM nhận một gói bằng chứng cho từng luận điểm: nguồn hỗ trợ, bằng chứng ngược, điều kiện và giới hạn. Đoạn văn phải giữ được các giới hạn ấy. Thay câu "Agent A tốt hơn" bằng một câu dài hơn nhưng đúng phạm vi vẫn tốt hơn việc bỏ điều kiện để bản thảo trôi chảy.
Bảng trước, graph sau
Mình sẽ bắt đầu với một nhóm paper đủ đa dạng để làm lộ vấn đề của schema: có nhiều reports cho một study, nhiều cấu hình trong một paper, metric khác định nghĩa, dữ liệu thiếu và kết quả nằm trong phụ lục. Khoảng 20-30 papers là đủ để schema vỡ ra ở những chỗ cần vỡ.
Người review gán nhãn một phần corpus trước, ghi cách giải quyết những trường hợp khó rồi kiểm tra extractor trên phần tài liệu giữ riêng. Nếu dùng cùng các đoạn đã sửa để vừa phát triển prompt vừa đánh giá, kết quả sẽ không phản ánh tốt lỗi trên paper mới.

Hình 8. Giữ model và ngân sách tương đương để tách riêng tác động của cách biểu diễn dữ liệu.
Ba baseline đáng so sánh là RAG trên toàn văn, extraction matrix có cấu trúc và evidence graph có provenance. Bảng và graph phải dùng cùng dữ liệu trích xuất, cùng trường nguồn, cùng quy tắc đánh giá, chỉ khác cách tổ chức và truy vấn. Bỏ riêng điều kiện, rồi bỏ riêng provenance, sẽ cho biết thành phần nào thực sự gánh việc.
Thứ đáng đếm là những lỗi làm hỏng công việc thật: gắn sai nguồn, đếm trùng study, so sánh hai kết quả không so sánh được, hoặc đề xuất một gap mà nghiên cứu khác đã trả lời. Cùng với đó là thời gian mình ngồi sửa lỗi của máy. Một hệ thống giảm lỗi tự động nhưng bắt mình gán nhãn gấp ba thì với nhóm nhỏ nó là một khoản lỗ.
Về biểu diễn, SKOS lo tên chuẩn, từ đồng nghĩa và quan hệ rộng/hẹp giữa các khái niệm, còn SHACL kiểm tra ràng buộc trên RDF graph. Hai thứ này bắt lỗi cấu trúc và lỗi dùng thuật ngữ, không bắt lỗi trong lập luận của paper. [10] [11]
Phiên bản đầu tiên mình sẽ lưu bằng typed JSON cùng vài bảng quan hệ, và chỉ đổi sang graph database khi đã biết rõ mình truy vấn gì và cập nhật ra sao. Tên riêng, phần trăm, đoạn văn thì không cần thành node. Nhưng thực nghiệm, phiên bản tài liệu và đánh giá khả năng so sánh thì đáng có định danh riêng, vì nhiều nhận định sẽ cùng trỏ về chúng.
Với review thiên về lý thuyết hoặc định tính, mô hình cần thêm Theory, Construct, Mechanism hoặc QualitativeFinding. Ép một diễn giải về cơ chế vào schema chỉ có score và benchmark thì phần thú vị nhất của nó rơi ra ngoài.
Bộ sơ đồ draw.io chỉnh sửa được đi kèm để ai muốn cãi thì sửa thẳng lên đó. Ba hướng mình thấy đáng thử riêng: đối chiếu điều kiện, bác bỏ false-gap claims, và cập nhật kết luận khi nguồn đổi.
Với mình, thử nghiệm đầu tiên vẫn là hai kết quả 60%. Công cụ có giữ được điều kiện và ngăn một câu kết luận quá rộng không? Nếu một extraction matrix làm được việc đó với ít công sửa hơn, mình sẽ dùng bảng trước. Chỉ sau khi gặp những câu hỏi mà bảng xử lý bất tiện, mình mới có lý do cụ thể để thêm graph.
Bình
Tài liệu tham khảo (11)
- Page MJ et al.. The PRISMA 2020 statement: An updated guideline for reporting systematic reviews. PLOS Medicine. 2021-03-29.
- Knowledge Graph. ORKG Academy.
- Jain S, van Zuylen M, Hajishirzi H, Beltagy I. SciREX: A Challenge Dataset for Document-Level Information Extraction. ACL. 2020-07.
- Wang Q, Downey D, Ji H, Hope T. SciMON: Scientific Inspiration Machines Optimized for Novelty. ACL. 2024-08.
- Baek J, Jauhar SK, Cucerzan S, Hwang SJ. ResearchAgent: Iterative Research Idea Generation over Scientific Literature with Large Language Models. NAACL. 2025-04.
- PROV-O: The PROV Ontology. W3C. 2013-04-30.
- Citation Typing Ontology (CiTO). SPAR Ontologies.
- OWL 2 Web Ontology Language Primer, Second Edition. W3C. 2012-12-11.
- Robinson KA, Saldanha IJ, McKoy NA. Frameworks for Determining Research Gaps During Systematic Reviews. AHRQ. 2011-06.
- SKOS Simple Knowledge Organization System Reference. W3C. 2009-08-18.
- Shapes Constraint Language (SHACL). W3C. 2017-07-20.