Outlook sập bởi vì production được triển khai trên Server KHOẺ HƠN server stress test ?? 😃 ??
Bản sửa Windows tháng 7 làm lock contention nặng hơn trên máy nhiều core. Mình đo trên hai máy và mô phỏng server khởi động lại vẫn kẹt.
Tối 12/11 tới tối 13/11 giờ Việt Nam, phần lớn người dùng Microsoft 365 không vào được hộp thư qua Outlook, mail của nhiều người bị chuyển trễ. Báo cáo sơ bộ Microsoft gửi khách hàng ngày 15/11 [1] ghi rằng lỗi nặng hơn trên máy nhiều core và phần cứng mới, còn load test của họ chủ yếu chạy trên máy yếu, ít core.
Đọc ngược câu đó thì server xịn hơn lại dễ chết hơn. Rồi vì sao một lần failover vốn là chuyện thường ngày lại làm hơn 80% server treo, và vì sao khởi động lại không cứu được?
Gateway của Microsoft 365 ngày 12/11

Kết nối từ Outlook tới Exchange Online, dịch vụ mail của Microsoft 365, đi qua một lớp server đứng trước mà Microsoft gọi là networking gateway.
Tháng 7/2026, Microsoft triển khai một bản sửa Windows làm riêng cho gateway server. Trong hơn 3 tháng, bản sửa chạy ngon choét trên toàn cầu. Nó mang theo một lỗi: dưới tải nhất định, một tiến trình nội bộ của Windows bị lock contention tới mức ăn hết CPU và bộ nhớ của máy.
Khoảng 15 giờ trước sự cố, Teams tự động failover từ gateway thứ hai sang gateway chính, cái Exchange Online cũng đang dùng. Cùng lúc đó gần 14% công suất của gateway đang nghỉ vì một lỗi khác từ hôm trước. Tải tăng, số máy giảm, gateway chạm lỗi tháng 7. Chưa tới 2 giờ, lỗi đã lan khắp dãy server.

Teams, OneDrive, SharePoint chuyển được ra khỏi gateway hỏng nên hồi một phần sớm hơn. Exchange Online thì quá lớn, không chuyển được. Server khởi động lại thì treo tiếp.
Bếp phở một cái muôi

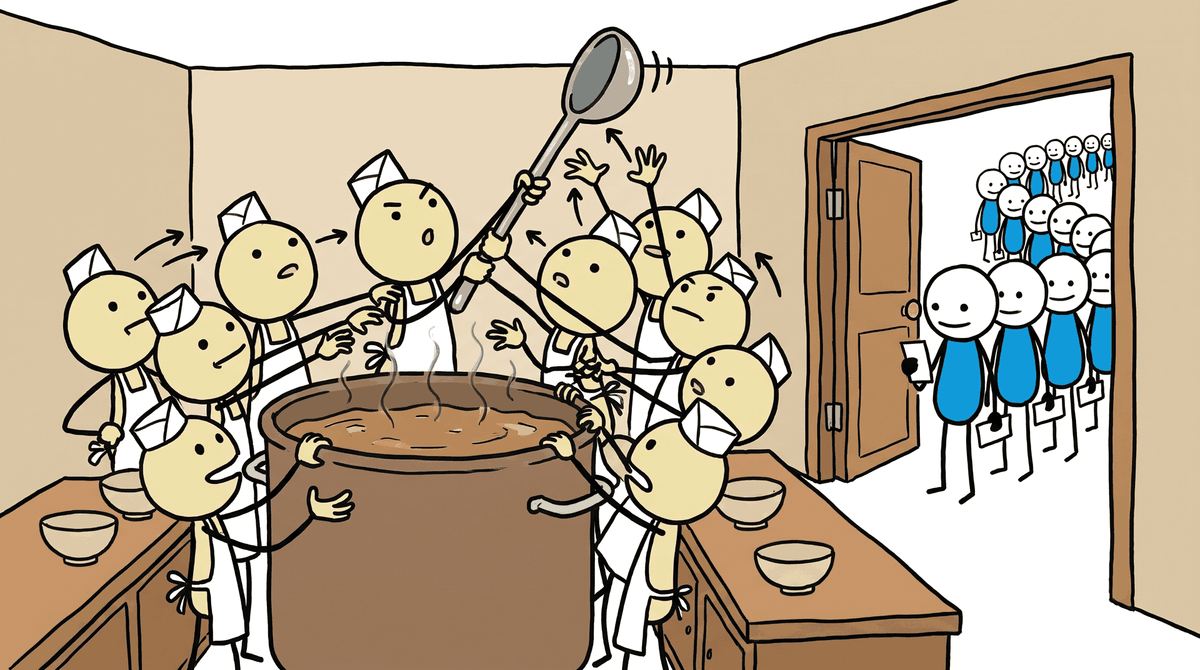
Bếp phở chỉ có một cái muôi: ai múc nước dùng thì cầm muôi, người khác chờ. Lock là thứ chương trình dùng để bắt các thread (luồng xử lý) xếp hàng y như vậy khi cùng sửa một dữ liệu chung.
Giả sử mỗi bát phở cần 25 giây việc riêng của đầu bếp (trụng bánh, xếp thịt) và 5 giây múc nước dùng bằng cái muôi chung. Chuyền muôi giữa hai người đứng cạnh nhau mất 1 giây. Khi cả bếp cùng chìa tay giành thì va nhau, giằng qua giằng lại, mỗi lần chuyền mất 4 giây.
1 đầu bếp làm 30 giây một bát, 120 bát mỗi giờ. 5 đầu bếp thì cái muôi bận 5 giây múc cộng 1 giây chuyền cho mỗi bát, trần 600 bát mỗi giờ, cũng gần bằng sức của 5 người. 10 đầu bếp thì ai cũng phải chờ muôi, mỗi lần chuyền thành 4 giây, cái muôi bận 9 giây cho mỗi bát. Cả bếp còn 400 bát mỗi giờ. Thuê thêm 5 người, quán làm ra ít phở hơn.
Đầu bếp là thread chạy trên một core, cái muôi là lock. Chuyền muôi là dữ liệu của lock chạy từ cache của core này sang cache của core kia. Càng nhiều core cùng giành, mỗi lần trao lock càng tốn. Chip càng to, chia thành nhiều cụm core, thì như bếp hai dãy, chuyền muôi qua dãy bên kia lại càng xa.
Còn cái muôi trong gateway là gì? Báo cáo chỉ nói lỗi nằm ở khâu thương lượng kết nối (connection negotiation). Mỗi lần Outlook mở kết nối mới tới server, hai bên bắt tay TLS để thống nhất khoá mã hoá. Kết nối quen thì server tra session cache để bắt tay nhanh hơn. Tài liệu Windows Server ghi rằng tăng thời gian giữ session cache TLS phía server thì Lsass.exe tốn thêm bộ nhớ, mỗi phiên 2 tới 4 KB [2]. Trên Windows, cache này nằm trong một tiến trình mà mọi kết nối TLS qua Schannel trên máy dùng chung. Mình đoán tiến trình bị lỗi là nó hoặc một tiến trình cùng vai trò, Microsoft chưa xác nhận.

Mình đo trên MacBook và DGX

Để thấy cái muôi bằng số, mình viết một chương trình C nhỏ. Mỗi thread lặp đi lặp lại: làm một đoạn việc riêng, lấy một lock chung, sửa 4 ô dữ liệu dùng chung, nhả lock. Mình thử bốn loại lock, từ loại đơn giản nhất tới loại được thiết kế cho nhiều core, rồi tăng dần số thread và đếm số vòng làm xong mỗi giây, tức throughput. Chương trình chạy trên hai máy: MacBook chip M4 Pro 12 core, và một máy chủ NVIDIA DGX 20 core Arm.

Trên MacBook, ba loại spinlock, loại lock mà thread chờ bằng cách quay vòng hỏi liên tục, tăng gần thẳng tới 8 thread, bằng số core hiệu năng cao của chip. Từ thread thứ 9 thì gãy. Lock đơn giản nhất đạt 4,83 triệu vòng mỗi giây ở 8 thread, xuống 3,61 triệu ở 9 thread, còn 2,14 triệu ở 12 thread. Thread thứ 9 trở đi rơi vào cụm 4 core tiết kiệm điện, vừa chậm hơn vừa xa hơn về cache, nên cú gãy ở đây là hai hiệu ứng cộng lại. Mutex của hệ điều hành thì đạt đỉnh sớm, 2,57 triệu ở 4 thread, rồi đi ngang dưới 2,1 triệu. Ai load test trên một máy 8 core với ba loại lock kia sẽ thấy đường đẹp và yên tâm.
Trên DGX, lock đơn giản nhất đạt đỉnh 4,69 triệu vòng mỗi giây ở 4 thread, rồi đi xuống đều. 20 thread còn 1,28 triệu, ít hơn cả lúc chạy 2 thread (2,36 triệu).
Năm 2012, nhóm MIT viết rằng họ nhiều lần gặp chuyện này: một hệ thống chạy tốt với 25 core thì sụp hẳn với 30, và đoạn code giữ lock thường rất ngắn [3]. Họ đo trên nhân Linux.

Còn vế "ăn hết CPU" trong báo cáo thì sao? Lock tốt nhất trong bốn loại giữ throughput trong khoảng 3,6 tới 4,1 triệu vòng mỗi giây tới 20 thread trên DGX, không sụp. Nhưng CPU tiêu cho mỗi triệu vòng tăng từ 0,77 giây ở 1 thread lên 5,48 giây ở 20 thread, hơn 7 lần. Các core chờ lock không ngồi yên, chúng quay vòng hỏi "tới lượt chưa" và đốt CPU vào đó. Trên một server thật, thời gian CPU bị đốt đó lẽ ra dùng để xử lý kết nối khác.
Hàng đợi giữ server ở trạng thái kẹt

Vì sao hết đông khách mà quán vẫn không hồi lại?
Buổi tối khách gọi 450 bát mỗi giờ. Mỗi đơn đang chờ kéo một đầu bếp vào bếp, đơn ít thì người ít, muôi chuyền nhẹ, 5 người làm thừa sức. Rồi quán bên cạnh đóng cửa, khách dồn sang, 20 phút liền có 700 bát mỗi giờ. Hàng dài ra, cả 10 đầu bếp lao vào bếp, giành muôi, quán chỉ ra 400 bát. Sau 20 phút đó hàng đã dồn thêm 100 bát. Khách về lại mức 450 bát mỗi giờ, chỉ bằng ba phần tư sức của 5 người. Nhưng hàng vẫn dài nên 10 người vẫn đứng bếp, quán vẫn ra 400 bát. Mỗi giờ hàng dài thêm 50 bát, không bao giờ ngắn lại.
Đóng cửa 15 phút dọn dẹp rồi mở lại cũng vô ích. Khách vẫn đứng ngoài, cửa mở là ùa vào, 10 người lại giành muôi. Cách thoát là chủ quán chỉ cho 5 người đứng bếp, 5 người kia nghỉ. 5 người ra 600 bát mỗi giờ, hơn mức khách gọi 150 bát. Làm vậy ngay khi hết đợt đông thì 100 bát dồn tan trong 40 phút.
Mình chạy kịch bản đó cho một server mô phỏng. Server có 20 thread, tốc độ xử lý lên xuống theo đường của lock đơn giản nhất đo trên DGX: đỉnh 1.000 request mỗi giây khi 4 request chạy cùng lúc, còn 274 khi cả 20 thread cùng chạy. Đây là đường đo từ chương trình C trên Linux, không phải tiến trình Windows bị lỗi. Request tới ngẫu nhiên, trung bình 400 mỗi giây, tức 40% đỉnh.

Không có gì xảy ra thì hàng đợi chỉ quanh 0 tới 3 request, cao nhất 5. Cho lưu lượng gấp đôi trong 2 giây rồi trả về 400: server kẹt luôn ở 20 thread, chỉ xử lý được khoảng 270 request mỗi giây, hàng đợi lên khoảng 2.400 ở giây thứ 20 và vẫn tăng. Khởi động lại ở giây 12 cũng vậy, bật lên là kẹt tiếp. Cùng cú dồn đó nhưng chỉ cho tối đa 4 request chạy cùng lúc, phần còn lại xếp hàng bên ngoài: hàng đợi cao nhất 10, cú dồn qua là về 1, 2 ngay.
Mình bỏ cú dồn, cho server chạy một phút ở các mức tải khác nhau, mỗi mức 10 lần. Ở 30 tới 40% đỉnh chưa lần nào kẹt. Ở 50%, 8 trên 10 lần tự kẹt chỉ vì lưu lượng ngẫu nhiên lúc nhiều lúc ít.

Dạng hỏng này có tên là sự cố metastable. Năm 2021, Bronson và cộng sự mô tả nó: hệ thống chạy hàng tháng, hàng năm trong một vùng dễ tổn thương mà vẫn khoẻ, rồi một tác nhân đẩy nó vào trạng thái hỏng, và một vòng phản hồi giữ nó ở đó kể cả khi tác nhân đã hết [4]. Nhóm đó cũng viết rằng người ta hay đổ lỗi cho tác nhân, còn nguyên nhân gốc là vòng phản hồi.

Gần 14% công suất nghỉ, nhưng báo cáo viết "dịch vụ còn đủ khoảng dư công suất" nên tự nó không gây gì. Mình đoán phép tính khoảng dư đó ngầm coi throughput tỷ lệ với số máy và số core. Throughput tụt khi thêm thread nên phép tính đó sai: tải trung bình thấp vẫn có thể đang nằm trong vùng dễ tổn thương. Còn câu "máy vừa quay lại đã bị lưu lượng đang chờ đè quá tải và treo tiếp" chính là quán phở mở cửa lại. Khởi động lại xoá hàng đợi trong máy, không xoá được hàng khách đang chờ bên ngoài.

Cả dãy server đổ theo nhau

Một server kẹt thì health check, phép kiểm định kỳ xem server còn trả lời không, đánh dấu nó hỏng. Load balancer, bộ chia lưu lượng, đưa khách của nó sang server khác. Bình thường đây là thiết kế đúng: một máy hỏng phần cứng thì khách không hề biết.
Lỗi phụ thuộc tải thì chính thiết kế đó thành dây chuyền. \(N\) server chia đều tải \(L\), mất \(k\) máy thì mỗi máy còn lại gánh \(\frac{L}{N-k}\). Gần 14% công suất nghỉ sẵn thì mỗi máy còn lại đã gánh thêm khoảng \(\frac{1}{1-0{,}14} - 1 \approx 16\%\). Cộng thêm Teams. Máy nào kẹt trước thì đẩy phần của nó sang hàng xóm, hàng xóm kẹt theo, rồi tới lượt máy tiếp theo. Trong mô hình của mình, máy mới nhiều core kẹt trước vì đường của nó đi xuống sớm và dốc.

Bạn có thể tự gây dây chuyền trên một dãy 40 server mô phỏng, nửa máy đời mới nhiều core, nửa máy đời cũ. Chỉnh phần trăm máy nghỉ sẵn và lượng tải chuyển sang, rồi bật giới hạn số request chạy cùng lúc để xem nó chặn được tới đâu.
Gateway thật có hàng nghìn cụm máy nhỏ chia theo vùng, giữa các vùng có vách ngăn để lỗi ở vùng này không lan sang vùng kia. Lần này vách ngăn không chặn được, báo cáo chỉ ghi là "do một vấn đề riêng".

Gỡ ra cũng chậm. Báo cáo viết rằng lỗi đã nằm đó nhiều tháng nên rollback, flighting (bật thay đổi cho từng nhóm nhỏ trước) và feature flag không gỡ nhanh được. Microsoft phải viết một bản vá đưa đoạn code xử lý kết nối về trạng thái tốt trước đó, rồi rút từng nhóm lớn server ra khỏi phục vụ, có lượt từ nửa vùng trở lên, vá, khởi động lại, mới đưa vào. Rút hẳn cả nhóm ra cũng là cách không cho khách ùa vào máy vừa khởi động.
Áp vào hệ thống của bạn

Không cần cỡ Microsoft mới dính chuyện này.
Load test trên đúng dòng máy production, cùng số core.
Đẩy tải tới khi throughput đi xuống chứ đừng dừng ở mức tải hiện tại cộng một khoảng an toàn. Biết điểm đỉnh nằm ở bao nhiêu request cùng lúc thì mới biết khoảng dư thật.
Đặt giới hạn số request chạy cùng lúc gần điểm đỉnh đó, phần dư xếp hàng bên ngoài hoặc bị từ chối sớm. Throughput lúc đó đứng ở đỉnh thay vì trượt dốc, và hàng đợi tan được.
Còn vụ Outlook thì báo cáo cuối của Microsoft hẹn ra ngày 20/11. Câu cần trả lời nhất trong đó là vì sao vách ngăn giữa các vùng đã không chặn được dây chuyền, và loại lock nào nằm trong bản sửa tháng 7.
Đào sâu: cache line và các loại lock
CPU không đọc ghi bộ nhớ từng byte mà theo từng khối 64 hoặc 128 byte gọi là cache line. Mỗi core giữ bản sao các cache line nó đang dùng trong cache riêng. Phần cứng có một giao thức để các bản sao không lệch nhau: core nào muốn ghi vào một cache line thì phải giành quyền giữ độc quyền, bản sao ở mọi core khác bị huỷ, lần sau chúng đọc lại phải xin bản mới.
Một lock là một ô nhớ, nằm trong một cache line.
Lock test-and-set là loại đơn giản nhất: thread chờ liên tục ghi số 1 vào ô lock và xem giá trị cũ, giá trị cũ là 0 thì coi như lấy được lock. Mỗi lần thử là một lần ghi, nên cache line của lock bị giành qua giành lại giữa mọi core đang chờ, kể cả core đang giữ lock lúc nó muốn nhả. Đây là bếp 10 người cùng chìa tay vào cái muôi.
Ticket lock giống bốc số ở ngân hàng: mỗi thread lấy một số thứ tự, rồi chờ tới khi ô "đang phục vụ" bằng số của mình. Các thread chờ chỉ đọc, đỡ hơn test-and-set. Nhưng mỗi lần ô "đang phục vụ" tăng lên, bản sao ở mọi core chờ bị huỷ, mọi core đều phải đọc lại, dù chỉ một core được vào. Chi phí mỗi lần trao lock vẫn tăng theo số core chờ. Đây là loại lock nhân Linux dùng thời nhóm MIT đo năm 2012 [3].
Lock MCS cho mỗi thread chờ một ô nhớ riêng, xếp thành hàng. Thread nhả lock chỉ ghi vào ô của người kế tiếp, nên mỗi lần trao lock chỉ một cache line đi từ một core sang một core. Vì thế trên DGX, MCS không sụp như hai loại trên. Nhưng throughput vẫn không vượt được đoạn code nằm trong lock, đoạn mỗi lúc chỉ một thread chạy.

Lock thứ tư trong thí nghiệm là mutex mặc định của hệ điều hành. Trên Linux, thread không lấy được lock thì ngủ ngay thay vì quay vòng, nên đường của nó gần như phẳng, không sụp. Đổi lại đỉnh của nó thấp nhất trong bốn loại, vì mỗi lần cho thread ngủ rồi đánh thức dậy đều phải nhờ kernel, và tính trên mỗi vòng làm xong nó còn tốn CPU hơn cả MCS.
Bình
Nguồn (4)
- Microsoft. Preliminary Post Incident Report EX1550543/MO1550821 (Microsoft 365, Exchange Online). Microsoft 365 admin center, bản chép nguyên văn trên Office Watch. 2026-11-15. Báo cáo sơ bộ của Microsoft: lỗi tranh khoá trong một tiến trình nội bộ của Windows từ bản sửa tháng 7/2026 cho gateway của Microsoft 365, nặng hơn trên máy nhiều core; Teams failover và 14% công suất đang nghỉ đẩy tải lên; hơn 80% server ngừng phản hồi lúc tệ nhất. Bản gốc chỉ có trong admin center của tenant.
- Microsoft. Transport Layer Security (TLS) registry settings. Microsoft Learn. 2026-11-18. Tài liệu Windows Server: bộ đệm phiên TLS phía server của Schannel làm Lsass.exe tốn thêm bộ nhớ khi tăng ServerCacheTime hay MaximumCacheSize, mỗi phần tử khoảng 2 KB tới 4 KB.
- Silas Boyd-Wickizer, M. Frans Kaashoek, Robert Morris, Nickolai Zeldovich. Non-scalable locks are dangerous. Linux Symposium 2012, MIT CSAIL. 2012-07-11. Khoá spin không co giãn trong nhân Linux làm thông lượng sụp đột ngột khi thêm core, ví dụ chạy tốt với 25 core và sụp hẳn với 30; đoạn tranh chấp gây ra thường rất ngắn. Thay bằng khoá co giãn như MCS thì tránh được.
- Nathan Bronson, Abutalib Aghayev, Aleksey Charapko, Timothy Zhu. Metastable Failures in Distributed Systems. HotOS 2021, ACM. 2021-06-01. Định nghĩa sự cố metastable: hệ thống chạy hàng tháng trong vùng dễ tổn thương, một tác nhân đẩy nó vào trạng thái hỏng mà vòng phản hồi giữ lại kể cả khi tác nhân đã hết. Nguyên nhân gốc là vòng phản hồi, không phải tác nhân.